먼저 읽어 주세요이 기록에는 시연 키트의 정답(심어 둔 문제 28건의 위치와 값)이 들어 있습니다. 키트로 직접 실습하실 분은 먼저 해 보고 읽으세요.
AI와 함께하는 연구 워크플로우 — 시연 세션의 요청, 판단, 실패와 수정, 산출물
한 연구 폴더에서 Claude Code에게 여섯 번 요청했습니다. 데이터 정리, 통계, 작성, 문헌을 차례로 밟고 원페이저와 이 기록까지 만들었습니다. 각 단계에서 무엇을 맡겼는지, 무엇을 근거로 판단했는지, 어디서 틀렸고 어떻게 고쳤는지를 그대로 남겼습니다. 숫자는 모두 분석 로그(notes/analysis-log.md)에 있는 값입니다.
00개요
작업 폴더
~/DEV/snubh-1021-demo/live (git 저장소 아님)
날짜
2026-10-21
모델·도구
Claude Opus 5.5, Claude Code. Python은 uv run --with … 임시 환경
데이터
data/hf_cohort.csv 302행 × 14열. UCI Heart Failure Clinical Records(CC BY 4.0)의 강의 시연용 사본이고, 원 연구는 Ahmad et al. (2017)의 심부전 환자 299명입니다. 원본은 data/original/에 있습니다.
규칙 파일
CLAUDE.md 한 장. 묻지 않고 지키는 규칙입니다.
CLAUDE.md 요지
원본 data/hf_cohort.csv와 data/original/은 수정하지 않는다. 정리본은 clean/에 새 파일로 쓴다.
순서를 건너뛰지 않는다: 품질 점검 → 시간 축 점검(결과가 정해진 뒤 값이 정해지는 변수 금지) → 가정 확인 후 검정. p값만 쓰지 않고 효과 크기와 95% 신뢰구간을 함께 쓴다.
코드는 직접 실행해 확인하고, 그림은 figures/에 축 라벨, 단위, n을 넣는다.
모든 분석은 notes/analysis-log.md에 덧붙인다(덮어쓰지 않음). 논문 문장의 숫자는 로그에 있는 숫자만 쓴다.
인용은 refs.md에 있고 DOI를 확인한 문헌만. 없으면 "추가 확인 필요"로 표시하고 지어내지 않는다.
보고 형식: 요약 3줄 → 품질 점검 → 분석 → 그림 제안 → 이 데이터로 답할 수 없는 것.
금지: 데이터에 없는 값을 추정해 채우기, 관찰 연구에서 인과 표현, 결측·이상치를 조용히 제외하기.
01흐름
여섯 번의 요청이 일곱 가지 일이 됐습니다. 마지막 요청 하나에 원페이저와 세션 로그가 함께 들어 있습니다.
flowchart LR
  %% @key: B, L
  %% @aux: H
  %% @alt: 여섯 번의 요청이 일곱 가지 일로 이어지고 마지막 두 산출물이 labs 로 올라가는 흐름
  Q["`**01 품질 점검**
정리본 299행`"]
  A["`**02 연관 요인**
Cox 290명 · 사망 93`"]
  W["`**03 구조화 초록**
244단어 · 꼬리표`"]
  D["`**04 결측 결정**
9셀 복원 안 함`"]
  R["`**05 근거 문헌**
refs 2편 · 후보 3편`"]
  B["`**06 원페이저**
CB-006 V1`"]
  L["`**07 세션 로그**
이 페이지`"]
  H["`**labs**
snubh-1021`"]
  Q -->|"clean/"| A
  A -->|"AN-1"| W
  W -->|"미결"| D
  D -->|"Methods"| R
  R -->|"초록"| B
  R -->|"기록"| L
  B --> H
  L --> H
그림 A. 세션 흐름. 앞 단계의 산출물이 다음 단계의 입력이 됩니다. 강조한 두 상자가 이번 마지막 요청의 산출물입니다.
flowchart LR
  %% @key: W
  %% @aux: O
  %% @alt: 원본 CSV 가 정리본, Cox 모형, 분석 로그, 초록, 원페이저로 이어지고 원본 사본은 검증에만 쓰이는 흐름
  S["`**원본 사본**
hf_cohort.csv 302행`"]
  O["`**원자료**
data/original 299행`"]
  C["`**정리본**
299행 · 기록 28건`"]
  M["`**Cox 모형**
290명 · 사망 93`"]
  G["`**분석 로그**
analysis-log · 그림 2장`"]
  W["`**초록**
숫자 48개 대조`"]
  F["`**refs.md**
DOI 확인 2편`"]
  B["`**원페이저**
CB-006`"]
  S -->|"qc_clean.py"| C
  O -->|"검증에만"| C
  C -->|"cox_death.py"| M
  M -->|"결과 기록"| G
  G -->|"로그 숫자만"| W
  F -->|"Background"| W
  W --> B
  G --> B
그림 B. 데이터 파이프라인. 정리 규칙은 시연용 사본 안의 증거만으로 정했고, 원자료(회색)는 마지막 검증에만 썼습니다. 초록에는 분석 로그에 있는 숫자만 들어갑니다.
02프롬프트 원문
사용자가 입력한 그대로입니다. 그림을 확인하는 동안 도구가 보낸 이미지 표시 알림 두 건은 사용자 입력이 아니어서 뺐습니다.
P1요청 1
data/hf_cohort.csv 의 품질을 점검해 주세요. 문제를 유형별 표로 보고하고, 각 문제의 처리 방침과 근거를 제안한 뒤 정리본을 clean/ 에 저장해 주세요.
P2
continue
P3
continue
P4요청 2
정리본으로 추적 기간 중 사망(DEATH_EVENT)과 연관된 요인을 분석해 주세요. 어떤 변수를 넣고 뺐는지 이유를 먼저 말해 주세요.
P5요청 3
analysis-log 에 있는 결과만으로 구조화 초록(Background, Methods, Results, Conclusions)을 250단어 안으로 써 주세요. 숫자마다 로그의 어느 항목에서 왔는지 표시해 주세요.
P6
continue
P7요청 4
되살리지 않고 현재 내용 그대로 명시하며 작성하자.
P8요청 5
초록의 Background 에 들어갈 근거 문헌을 붙여 주세요. refs.md 에 없는 문헌이 필요하면 후보만 제시하고 DOI 확인 전에는 인용하지 마세요.
P9요청 6
두 가지 일을 하자.
하나는 cmds-brief 스킬 사용해서 이 연구에 대한 원페이저 만들어줘. v1 버전으로 진행.
둘은 현재 세션의 wd, prompt, 세션 기록, 산출한 결과물 모두 정리해서 pele 도식과 함께 이해할 수 있는 세션 로그 기록을 html로 만들어줘.
두 개 모두 작업 후 labs 에 업데이트
03세션 기록
요청마다 한 일, 판단과 근거, 실패와 수정을 나눠 적었습니다. 대괄호 꼬리표([QC-1a] 등)는 분석 로그의 항목입니다.
요청 1 · P1–P3 · 로그 [QC-1]
데이터 품질 점검과 정리본
한 일
코드북, 분석 로그, 문헌 목록, 시연 프롬프트를 먼저 읽었습니다. 기본 Python에 pandas가 없어 uv run --with pandas 임시 환경으로 실행했습니다.
scripts/qc_clean.py로 정리했습니다. 302행에서 완전 중복 3행을 지워 299행이 됐고, 셀 단위 변경 기록 28건을 남겼습니다 [QC-1].
원자료와 셀 단위로 대조했습니다. 3887셀 중 일치 3878, 결측으로 둔 셀 9, 불일치 0 [QC-1d]. 원본 두 파일의 SHA-256은 실행 전후 같았습니다.
시연용으로 미리 만들어 둔 정답표와 대조하니 심어 둔 28건이 모두 일치했습니다. 정답표에 적힌 원자료의 특성 세 가지(소수 나이, 혈소판 263358.03, time 누수)도 모두 찾았고, 정답표에 없던 CPK 582(47건)의 평균 대치를 추가로 찾았습니다.
판단과 근거
변환식이 하나로 정해질 때만 고친다. 표기 통일(M/F, yes/no → 0/1)과 크레아티닌 단위 환산(µmol/L ÷ 88.4 → mg/dL)만 고쳤습니다 [QC-1a].
참값을 정할 수 없으면 결측으로 둔다. EF 0과 120, 나트륨 1360 [QC-1a].
평균 대치 의심값은 지우지 않고 표시한다. 혈소판 263358.03은 나머지 274건의 평균과 같고, CPK 582는 나머지 252건 평균 581.81을 반올림한 값입니다. 표시 열 두 개를 더했습니다 [QC-1a].
time은 예측 변수로 쓰지 않는다. 사망하면 관찰이 끝나 결과가 값을 정합니다. 사망 96명의 중앙값은 44.5일, 사망하지 않은 203명은 172일입니다 [QC-1c].
교훈 — 나트륨 1360. "소수점이 밀렸다"는 그럴듯한 규칙을 썼다면 136을 넣었을 것입니다. 원자료 값은 131이었습니다 [QC-1d]. 그럴듯한 추정으로 고치면 틀린 값을 만들어 넣게 됩니다.
실패와 수정정수 열이 75.0처럼 실수로 저장됐습니다. 해당 셀이 없는데도 빈 선택에 NaN을 대입한 줄이 열 형식을 바꿨기 때문입니다. 셀이 있을 때만 대입하고, 정수로만 된 열은 결측이 있어도 정수형(Int64)으로 저장하게 고쳤습니다.
요청 2 · P4 · 로그 [AN-1]
추적 기간 중 사망과 연관된 요인 — Cox 모형
설계 (분석 전에 정함)
Cox 비례위험 모형. 추적 기간이 4~285일로 제각각이라 사망하지 않은 환자는 중도절단입니다. 로지스틱 회귀는 이 차이를 무시합니다 [AN-1a].
뺀 것:time(시간 축으로만), patient_id, 대치 의심 표시 열(민감도 분석에만).
넣은 것: 기저 임상 변수 11개 전부. 자료를 보고 변수를 고르는 단계적 선택은 하지 않았습니다. CPK와 크레아티닌은 왜도가 4.67, 4.42라 log2로 넣었습니다 [AN-1a].
결측: 완전 사례 290명(사망 93). EF 결측 8명과 나트륨 결측 1명을 제외했고, 제외자 사망률 33.3%는 포함자 32.1%와 비슷합니다 [AN-1b].
가정 점검
공선성: 최대 |Spearman r| 0.44, VIF 최대 1.33 [AN-1c].
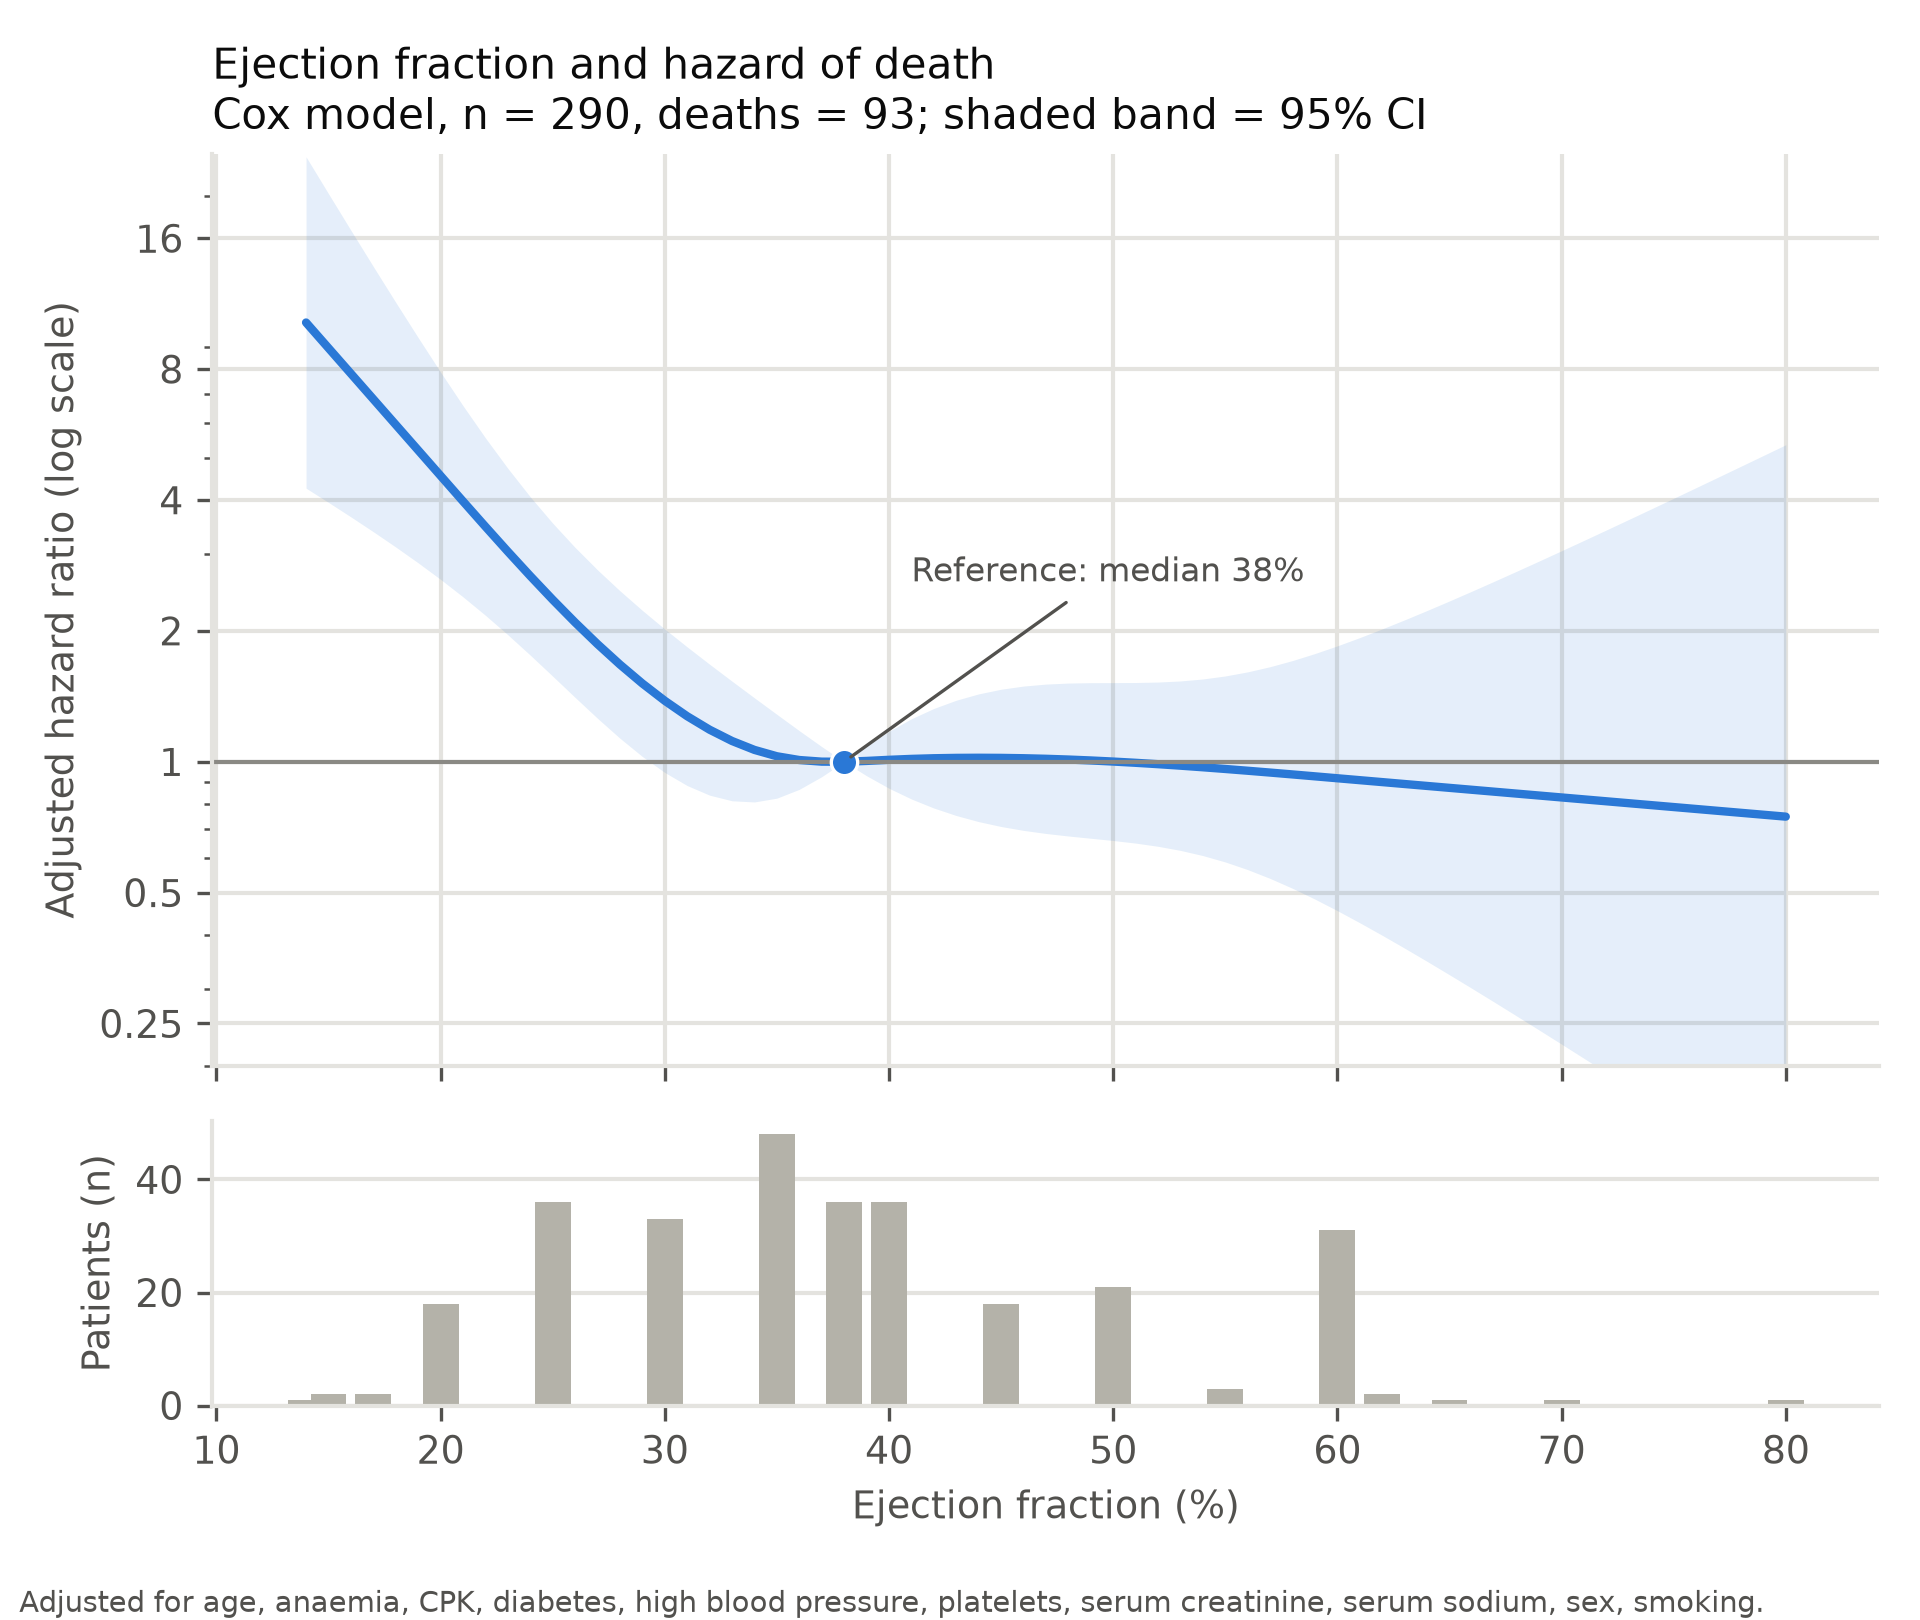
선형성: 매듭 3개와 4개 두 설정 모두 p<0.05일 때만 스플라인을 쓰기로 했고, EF만 해당했습니다(p 0.003, 0.005). CPK는 0.954와 0.031로 매듭에 따라 결론이 뒤집혀 선형으로 두었습니다. 4매듭 중 하나가 마침 대치값 위치에 놓였습니다 [AN-1c].
비례위험: EF를 직선으로 넣으면 p=0.021로 위반이었습니다 [AN-1c].
flowchart LR
  %% @key: S4
  %% @aux: R, C
  %% @alt: EF 를 직선으로 넣으면 비례위험이 깨지고 매듭 3개로도 남아 매듭 4개에서 해소된 결정 경로
  R["`**채택 규칙**
매듭 3·4개 모두 0.05 미만`"]
  L["`**EF 직선**
비선형 p 0.003 · PH p 0.021`"]
  S3["`**EF 매듭 3개**
PH p 0.022 · 위반 남음`"]
  S4["`**EF 매듭 4개**
PH 최소 p 0.172`"]
  K["`**주 모형**
13모수 · 모수당 사건 7.2`"]
  C["`**CPK**
매듭 3개 0.954 · 4개 0.031`"]
  R -->|"EF 해당"| L
  R -->|"뒤집힘 → 선형 유지"| C
  L -->|"스플라인으로"| S3
  S3 -->|"매듭 늘림"| S4
  S4 -->|"채택"| K
그림 C. EF 모형 결정 경로. 비례위험 위반은 효과가 시간에 따라 달라서가 아니라 곡선을 직선으로 넣은 탓이었습니다. 모수를 아끼려 고른 매듭 3개로는 위반이 남았고, 매듭 4개에서 해소됐습니다 [AN-1c].
실패와 수정 1 — 스플라인 기저patsy cr() 기저는 행의 합이 1이라 평균을 빼면 열끼리 선형 종속이 되어 적합이 실패했습니다. Harrell 방식 제한 3차 스플라인 기저를 직접 만들어 해결했습니다 [AN-1c].
실패와 수정 2 — 오류 없는 수렴 실패CPK 대치값을 뺀 부분집합에서 포함 관계인 두 모형의 LR이 음수(−24.8)로 나왔습니다. 기저 열의 상관이 0.995라 최적화가 최대가능도 전에 멈췄는데, lifelines는 경고 없이 결과를 돌려줬습니다. 모든 적합을 statsmodels 로그가능도와 대조하도록 fit()에 검사를 넣었고(전체 선형 모형은 둘 다 −452.222), 이 부분집합 결과는 쓰지 않았습니다 [AN-1c].
실패와 수정 3 — 그림차트 지침(dataviz)을 먼저 읽고 그렸습니다. 렌더한 그림을 직접 열어 보니 포리스트 플롯의 x축이 실제 신뢰구간보다 넓게 열려 오른쪽이 비었고, 점 테두리가 두꺼워 짧은 신뢰구간이 끊긴 점선처럼 보였습니다. 축 범위를 좁히고 테두리를 얇게 고쳤습니다.
요청 3 · P5–P6 · 로그 [WR-1]
구조화 초록
숫자마다 출처 로그 항목을 꼬리표로 달았습니다. 연구 시기와 장소는 코드북에만 있고 로그에 없어서 넣지 않았습니다 [WR-1].
꼬리표 바로 앞 숫자와 신뢰구간 쌍 45개를 해당 로그 항목 본문과 문자열로 대조했고 불일치는 0이었습니다. 인과·예측 표현도 0이었습니다 [WR-1].
처음 초안은 280단어로 넘쳤습니다. 숫자는 그대로 두고 문장만 줄여 본문 244단어(소제목 포함 248)로 맞췄습니다 [WR-1].
요청 4 · P7 · 로그 [DEC-1], [WR-2]
결측 9셀을 되살리지 않기로 한 결정
사용자가 결측 9셀(EF 8, 나트륨 1)을 원자료 값으로 되살리지 않고 현재 정리본 그대로 쓰기로 정했습니다. 그래서 Cox 분석 결과는 그대로 유효하고 다시 돌리지 않았습니다 [DEC-1].
초록 Methods에 "값을 대치하지 않았다"와 "완전 사례 분석으로 9명 제외(EF 8, 나트륨 1)"를 넣었습니다. 분량이 넘쳐 다른 문장을 줄였고, 숫자는 바꾸지 않았습니다. 대조한 숫자는 48개가 됐고 모두 일치했습니다 [WR-2].
즉석에서 돌리던 대조를 scripts/check_abstract.py로 파일에 남겼습니다. 숫자 출처, 꼬리표 없는 숫자, 단어 수, 인과 표현 중 하나라도 어긋나면 종료 코드 1을 냅니다 [WR-2].
요청 5 · P8 · 로그 [REF-1]
Background 근거 문헌
refs.md의 두 문헌이 문장을 실제로 뒷받침하는지 제목이 아니라 초록으로 확인했습니다. DOI로 Europe PMC에서 받아 읽었습니다: ahmad2017(PMID 28727739, 이 코호트의 원 연구, 같은 11개 변수로 Cox 회귀), chicco2020(PMID 32013925, 같은 299명 자료, 크레아티닌과 EF만으로 생존 예측) [REF-1].
Background 첫 문장은 심부전 전반에 대한 주장인데 두 문헌은 우리가 분석한 바로 그 자료라 근거가 좁습니다. [추가 확인 필요: C1–C3]를 남겼습니다 [REF-1].
더 넓은 근거 후보로 Rahimi 2014(체계적 문헌고찰), Pocock 2013(MAGGIC), Levy 2006(Seattle HF Model)을 찾았습니다. Crossref 확인 전이라 인용하지 않았고 refs.md에도 넣지 않았습니다 [REF-1].
검사 스크립트에 인용 키 대조를 더했습니다. refs.md에 없는 키를 쓰면 종료 코드 1입니다 [REF-1].
실패와 수정 — 검사를 검사하기없는 키를 넣은 사본으로 음성 대조를 했는데 exit=0이 찍혔습니다. 파이프 뒤 tail의 종료 코드였습니다. 파이프 없이 다시 돌려 없는 키를 넣은 사본과 HR 하나를 일부러 바꿔 쓴 사본이 모두 종료 코드 1, 실제 초안은 0임을 확인했습니다 [REF-1].
세션 로그: 이 페이지입니다. Pele 도식 네 장과 함께 요청, 판단, 실패와 수정, 산출물을 정리했습니다.
배포 전 확인: labs 작업 폴더에 다른 작업의 커밋하지 않은 변경이 있었습니다. vercel deploy는 폴더를 통째로 올리므로, 라이브와 로컬 파일 해시를 비교해 같음을 먼저 확인했습니다(작업 폴더가 곧 배포된 상태).
공개 범위 결정: 강의 폴더에서 시연자 정답표를 찾아 [QC-1]과 대조했습니다. 심은 28건이 모두 일치했고, 그 결과 이 기록과 원페이저가 사실상 키트의 정답을 담는다는 것이 드러났습니다. 사용자에게 물어 "경고를 넣고 허브에 링크"로 정했습니다 [QC-2].
원페이저 판정: 라우터 v1 11점, v3 7점, 1·2위 차 4점. 사용자 지정(v1) = 사전 선택 = 라우터 1위라 v1 하나만 빌드했습니다.
검증 관문: G1 검사기 0건 → G2·G3는 초안을 쓰지 않은 별도 검증 에이전트가 원 연구 초록과 본문까지 대조 → G4 A4 1쪽·390px 점검 통과. 결재(G6) 전이라 지면에 "시안"이 찍힙니다.
labs:/brief/cb-006/(웹 + PDF)과 이 페이지를 올리고, 두 경로에 noindex 헤더와 끝 슬래시 리다이렉트를 더했습니다. 허브 snubh-1021 카드에 "정답 포함" 표시를 단 링크 세 개를 넣었습니다.
실패와 수정 — "단일 기관"은 오독이었습니다원 연구 초록의 "Institute of Cardiology and Allied hospital Faisalabad"를 "심장연구소와 연계 병원", 곧 단일 기관으로 읽었습니다. 검증 에이전트가 같은 자료를 쓴 재분석 논문 본문의 "at the Faisalabad Institute of Cardiology and at the Allied Hospital"을 근거로 두 병원이라고 지적했고, 원페이저를 "한 도시 두 병원"으로 고쳤습니다. 같은 검증에서 "평균 대치값이다"라는 단정(로그는 "의심"), 결과를 방법처럼 쓴 Takeaways, 변수 선택처럼 읽히는 그림 설명("세 요인이 남았다")도 고쳤습니다. 숫자 대조는 처음부터 전부 일치했습니다.
실패와 수정 — 지면 넘침은 내용으로 줄였습니다첫 빌드에서 "남은 질문" 한 줄이 셋째 단으로 밀려 A4 밖에 놓였습니다. 글자를 줄이지 않고 결과표의 빈혈·고혈압 두 행을 문단으로 옮기고, 한 줄 답과 해볼 일 2번을 짧게 쓰고, 설계표와 겹치는 근거표 한 행을 뺐습니다.
04결과
품질 점검 — 유형별 처리 [QC-1a]
유형
변수
건수
처리
근거
중복
행 전체
3행
뒤 행 삭제
ID와 13개 값이 모두 같음
표기 불일치
sex
7
M→1, F→0
코드북 코딩
표기 불일치
smoking
4
yes→1, no→0
코드북 코딩
결측
EF
6
결측 유지
채울 근거 없음
단위 혼입
크레아티닌
5
÷88.4 → 0.70~1.90 mg/dL
나머지 최대 9.4와 62 사이 빈 구간, 환산값이 기존 분포 안
생리적 불가능
EF
2
결측 처리
120은 정의상 불가, 0인데 이후 72일 관찰
생리적 불가능
나트륨
1
결측 처리
허용 범위 100~180 밖
평균 대치 의심
혈소판
25 (8.4%)
값 유지 + 표시
263358.03 = 나머지 274건 평균
평균 대치 의심
CPK
47 (15.7%)
값 유지 + 표시
582 ≈ 나머지 252건 평균 581.81
주 모형 — 보정·비보정 위험비 [AN-1e]
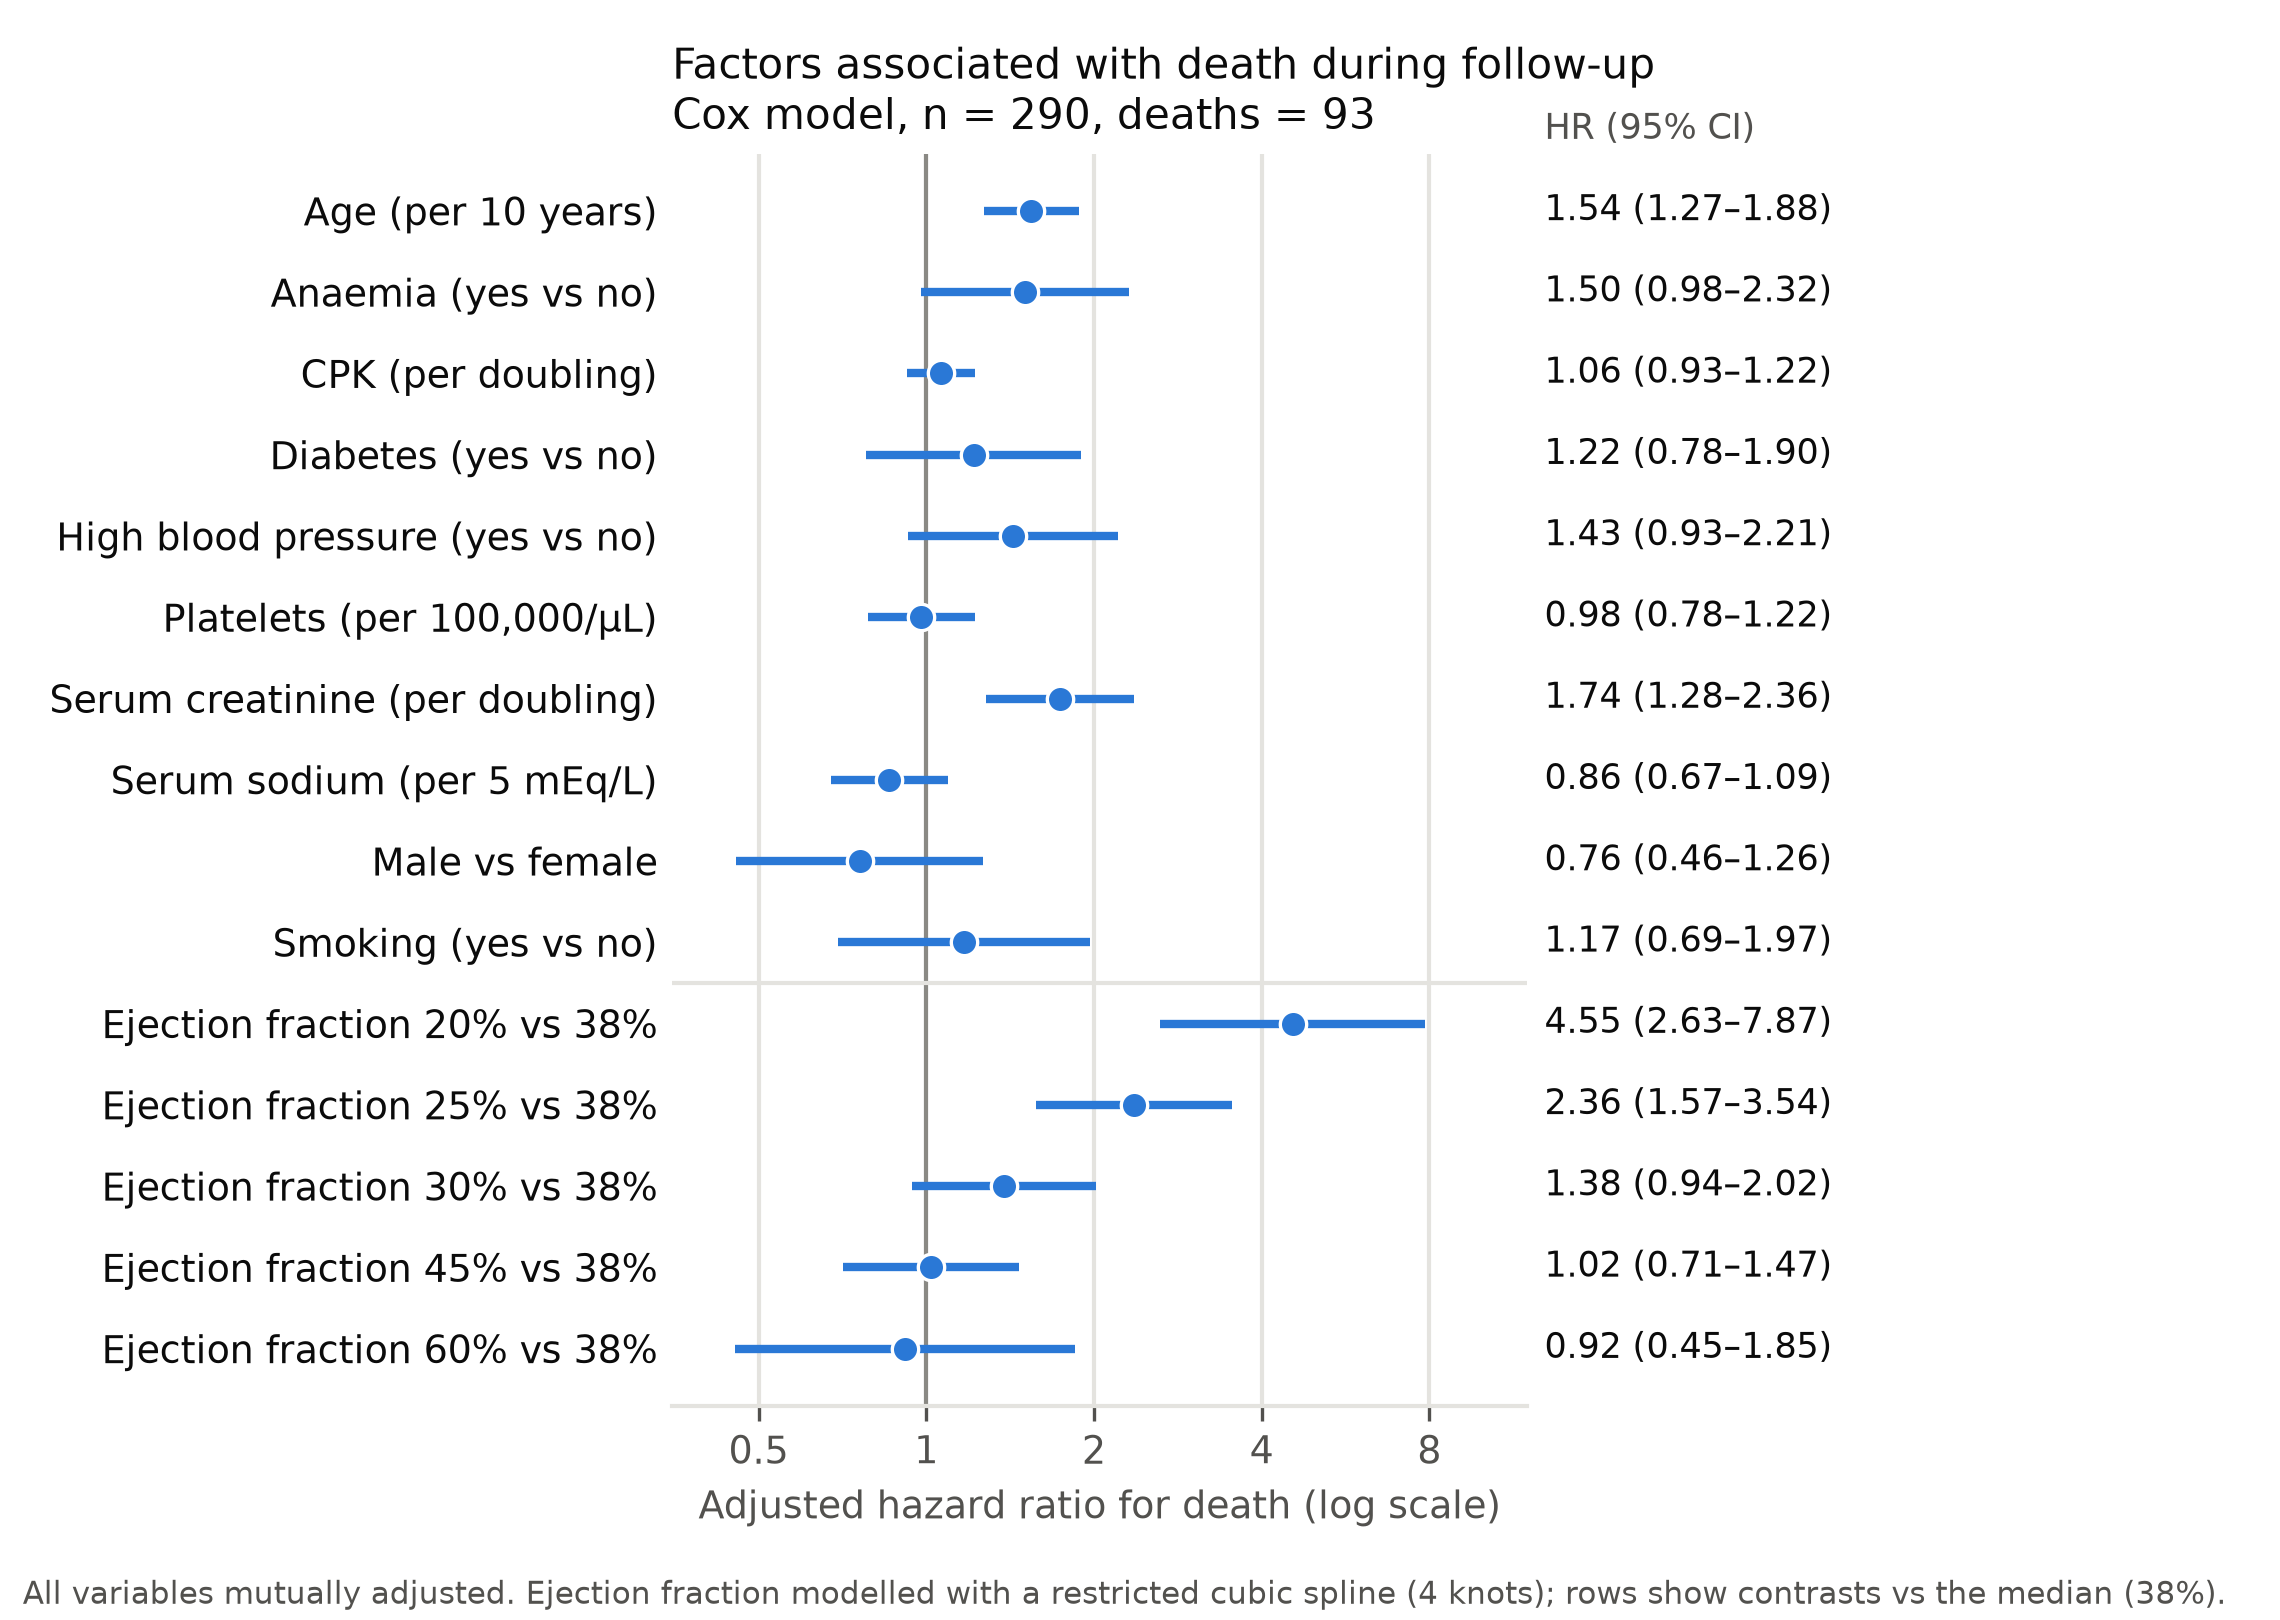
n=290, 사망 93. EF는 제한 3차 스플라인(매듭 4개), 나머지는 선형. 겉보기 C-index 0.760(내부 검증 안 함). 다중 비교 보정 없음(탐색적).
변수
비보정 HR (95% CI)
보정 HR (95% CI)
p (보정)
나이 (10년당)
1.50 (1.26–1.79)
1.54 (1.27–1.88)
<0.001
빈혈
1.33 (0.89–2.01)
1.50 (0.98–2.32)
0.063
CPK (2배당)
1.00 (0.88–1.13)
1.06 (0.93–1.22)
0.387
당뇨
1.00 (0.66–1.51)
1.22 (0.78–1.90)
0.388
고혈압
1.51 (1.00–2.29)
1.43 (0.93–2.21)
0.104
혈소판 (10만/µL당)
0.93 (0.76–1.16)
0.98 (0.78–1.22)
0.851
크레아티닌 (2배당)
2.04 (1.62–2.55)
1.74 (1.28–2.36)
<0.001
나트륨 (5 mEq/L당)
0.71 (0.59–0.86)
0.86 (0.67–1.09)
0.215
남성 (vs 여성)
0.97 (0.64–1.48)
0.76 (0.46–1.26)
0.290
흡연
0.94 (0.60–1.47)
1.17 (0.69–1.97)
0.560
EF 20% vs 38%
5.51 (3.34–9.09)
4.55 (2.63–7.87)
—
EF 25% vs 38%
2.75 (1.88–4.03)
2.36 (1.57–3.54)
—
EF 30% vs 38%
1.54 (1.07–2.22)
1.38 (0.94–2.02)
—
EF 45% vs 38%
1.00 (0.70–1.41)
1.02 (0.71–1.47)
—
EF 60% vs 38%
1.23 (0.63–2.41)
0.92 (0.45–1.85)
—
관찰 연구의 연관이며 인과가 아닙니다. 나이, 크레아티닌, EF 25% 대비의 방향과 크기는 민감도 분석 네 가지에서 유지됐고, 빈혈과 고혈압은 모형에 따라 신뢰구간이 1을 넘나들어 결론을 미뤘습니다 [AN-1f].
그림 1. 보정 위험비 포리스트 플롯(figures/fig1_forest_adjusted_hr.png). 로그 축, n=290, 사망 93.그림 2. EF와 사망 위험 곡선, 95% 신뢰구간 띠와 아래 EF 분포 패널(figures/fig2_ef_spline_hr.png). 기준은 중앙값 38%.
구조화 초록 — 현재 초안
notes/abstract-draft.md 그대로입니다. 초록 꼬리표는 로그 항목, 회색은 refs.md 인용, 붉은 표시는 아직 근거를 확인하지 않은 자리입니다. 투고할 때 꼬리표는 지웁니다.
Background: Baseline characteristics associated with mortality may help identify higher-risk patients with heart failure [@ahmad2017; @chicco2020][추가 확인 필요: C1–C3]. We examined factors associated with death during follow-up in a public heart failure cohort [@ahmad2017].
Methods: After removing 3 duplicate records [QC-1a], 299 patients remained [QC-1e]. Unit errors were corrected and impossible values set to missing; no values were imputed [QC-1a]. Complete-case analysis excluded 9 patients lacking ejection fraction (EF; n=8) or sodium (n=1) [AN-1b]. Follow-up ranged from 4 to 285 days [AN-1a]. Cox models included all 11 baseline variables; follow-up time served only as the time scale [AN-1a]. Creatinine phosphokinase and serum creatinine were log2-transformed; EF was modelled with a 4-knot restricted cubic spline chosen after assumption checks [AN-1c]. A sensitivity analysis excluded 59 patients with suspected mean-imputed laboratory values [AN-1f].
Results: Of 290 patients analysed, 93 (32.1%) died [AN-1b]. After adjustment, older age (hazard ratio [HR] per 10 years 1.54, 95% CI 1.27–1.88) and higher serum creatinine (HR per doubling 1.74, 1.28–2.36) were associated with higher hazard of death [AN-1e]. EF showed a non-linear association: versus the median of 38% [AN-1d], HRs were 4.55 (2.63–7.87) at 20% and 2.36 (1.57–3.54) at 25%, with no clear difference at 45% (1.02, 0.71–1.47) [AN-1e]. The unadjusted sodium association (HR per 5 mEq/L 0.71, 0.59–0.86) attenuated after adjustment (0.86, 0.67–1.09) [AN-1e]. Age, creatinine and EF estimates were robust to sensitivity analyses; anaemia and high blood pressure estimates were imprecise [AN-1f].
Conclusions: Older age, higher serum creatinine and markedly reduced EF were associated with higher hazard of death, with no clear gradient above median EF. These exploratory observational findings need independent confirmation.
05산출물
경로는 작업 폴더 기준입니다. 입력 파일(data/, CLAUDE.md, refs.md, prompts/)은 읽기만 했습니다.
경로
설명
요청
clean/hf_cohort_clean.csv
정리본 299행 × 16열 (원래 14열 + 평균 대치 의심 표시 2열)
1
clean/qc_changes.csv
바꾼 셀과 지운 행 28건의 전후 값, 유형, 규칙
1
scripts/qc_clean.py
품질 점검, 정리, 원자료 대조 검증 (정리 규칙에는 원자료를 쓰지 않음)
1
scripts/cox_death.py
Cox 분석: 표본, 기저 특성, 가정 점검, 주 모형, 민감도 분석, 그림 두 장. 모든 적합을 두 엔진으로 대조
2
figures/fig1_forest_adjusted_hr.png
보정 위험비 포리스트 플롯
2
figures/fig2_ef_spline_hr.png
EF 스플라인 위험비 곡선과 EF 분포
2
scripts/check_abstract.py
초록 검사: 꼬리표별 숫자와 CI 쌍, 꼬리표 없는 숫자, 단어 수, 인과 표현, 인용 키
4–5
notes/abstract-draft.md
구조화 초록 초안과 문헌 절(인용한 문헌, 미인용 후보 C1–C3)
3–5
notes/analysis-log.md
분석 로그. [QC-1], [AN-1], [WR-1], [DEC-1], [WR-2], [REF-1]을 덧붙임
1–5
볼트 40. Docs/42. AI Generated/Research/2026-10-21-UCI-Heart-Failure-데이터셋의-숨은-평균-대치-(PLT-263358.03,-CPK-582).md
작업 기록(research): 공개 원자료의 평균 대치 흔적과 판별법
1
볼트 40. Docs/42. AI Generated/Troubleshooting/2026-10-21-Cox-스플라인-LR-검정이-음수-—-lifelines-무경고-수렴-실패와-patsy-cr-기저-공선.md
단계마다 결과를 믿기 전에 확인하는 장치를 하나씩 두었고, 마지막에는 그 장치가 실패를 실제로 잡는지도 확인했습니다.
flowchart LR
  %% @key: N
  %% @alt: 데이터, 분석, 작성 단계마다 둔 검증 장치와 실패를 잡는지 확인한 음성 대조
  H["`**SHA-256**
원본 두 파일 전후 동일`"]
  V["`**원본 대조**
3887셀 · 불일치 0`"]
  F["`**fit() 교차 확인**
lifelines = statsmodels`"]
  P["`**가정 점검**
선형성 · 비례위험`"]
  X["`**check_abstract.py**
숫자 · 단어 · 인용 키`"]
  N["`**음성 대조**
없는 키 · 숫자 오기 → 1`"]
  H -->|"정리"| V
  V -->|"분석"| F
  F --> P
  P -->|"작성"| X
  X -->|"실패를 잡나"| N
그림 D. 검증 장치. 데이터 단계는 해시와 원자료 대조, 분석 단계는 두 엔진의 로그가능도 대조와 가정 점검, 작성 단계는 초록 검사 스크립트와 그 음성 대조입니다.
SHA-256: 분석 스크립트를 돌릴 때마다 원본 두 파일의 해시가 그대로인지 확인했습니다 [QC-1].
원자료 대조: 정리 규칙에는 쓰지 않고, 정리가 끝난 뒤 셀 단위 검증에만 썼습니다 [QC-1d].
 CMDSPACE LABS · SNUBH 1021