2026-07-05파일럿완료합성 응답(진단)
파일럿 v0.1
- 질문
- 합성 페르소나 설문이 실행 가능한가, 응답에서 어떤 유형이 나오는가?
- 규모
- 50명
- 조건
- 미래모빌리티 28문항 예행
- 보고서
- 보고서 미수록
핵심 결과 — 수용성 유형 6종을 처음 도출하고, 문항·제시문 구조를 미래상 중심으로 바꿀 근거를 얻었다.
- 한계
2026-07-24데이터셋 검증완료합성 응답(진단)
표본 구축과 데이터셋 검증
- 질문
- 원천 합성 인물 데이터셋에서 뽑은 1,000명이 인구 분포를 얼마나 따르는가?
- 규모
- 쿼터 1,000명 + 레드팀 20명
- 조건
- 연령대·성·시도 셀별 인구 비율 배분 · 셀 안 무작위 추출(시드 42) · 실행 전 명단 동결
- 보고서
- 제2장 제2절, 제9장 제3·6절
핵심 결과 — 원천 자료 100만 명 대비 표본 편차는 학력 최대 1.54%p, 전체 항목 최대 1.93%p(가구형태)였다. D-29 D-1
- 한계
- 확률표본이 아니며 학력·가구·혼인은 배분 기준이 아님
- 주변 분포가 맞아도 변수 간 결합구조의 재현은 보장하지 않음
2026-08-08파일럿완료합성 응답(진단)
파일럿 v0.3
- 질문
- 여섯 미래상 제시문에 대한 수용도 순위와 입장 분포가 어떤 모습인가?
- 규모
- 50명 × 100문항 × 제시문 S0~S6, 1회
- 조건
- 서베이 v0.3
- 보고서
- 보고서 미수록 (재현 판정은 제9장 제10절 후속 과제)
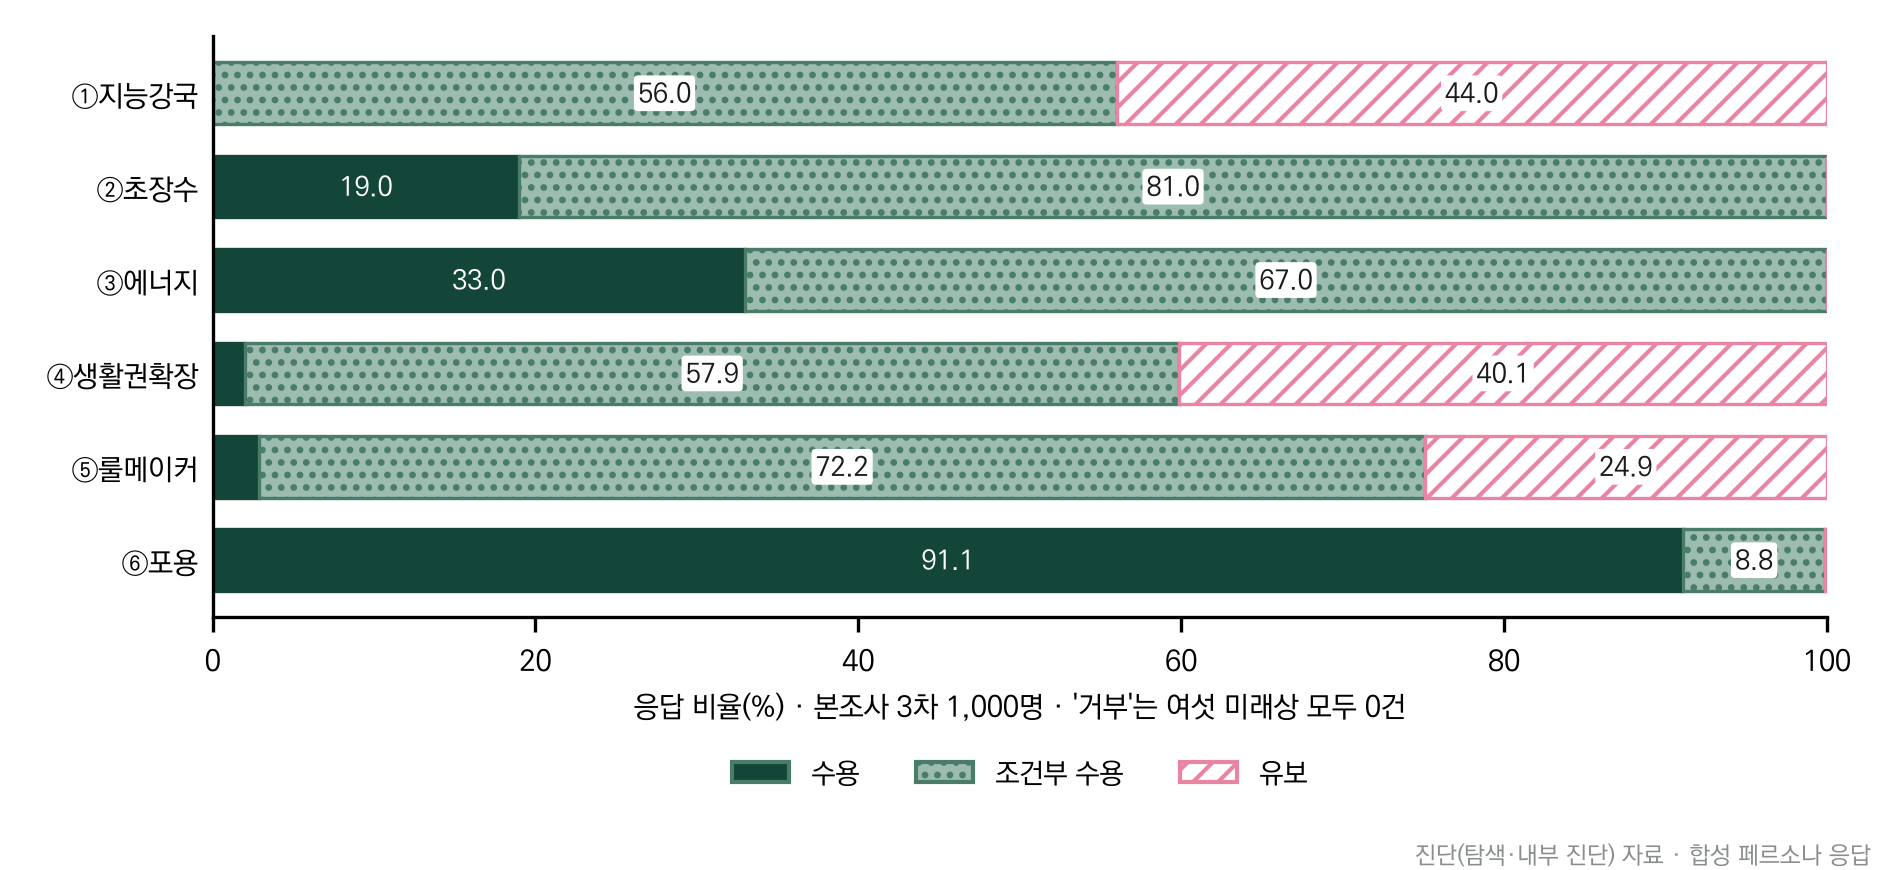
핵심 결과 — 수용도 순위 ⑥포용(4.12) > ③에너지 > ②초장수 > ⑤룰메이커 > ④생활권 확장 > ①지능강국(2.53). 9/2 중간점검 때 본조사 1차 앞 구간(1,000명 중 535명 완료 시점)과의 순위 일치도는 τ=0.87이었다. 이는 중간 신호이며, 문항 판본과 페르소나가 달라 재현 판정은 아니고 보고서는 정식 판정을 후속 과제로 남겼다(제9장 제10절).
- 한계
2026-08-08트윈·grounding완료합성 응답(진단)
트윈 스터디: 문서 기반 페르소나 대 통계 클론
- 질문
- 한 사람의 문서로 만든 페르소나와, 그 사람과 인구 속성이 가장 가까운 통계 클론은 얼마나 같은 답을 하는가?
- 규모
- 1쌍(연구책임자 본인 문서 기반 대 최근접 통계 클론)
- 조건
- 서베이 v0.3
- 보고서
- 보고서 미수록
핵심 결과 — 통계 클론은 기대·체감 같은 계층 수준 축을 2백분위 이내로 맞췄으나, 가치 트레이드오프(양자택일 동일극 11/17)와 종합 입장(2/6)은 놓쳤다. '계층은 맞추고 사람은 놓친다.'
- 한계
- 사례 1쌍
- 연구책임자 본인을 기준으로 한 자기 검증
2026-08-10트윈·grounding완료합성 응답(진단)
grounding gradient
- 질문
- 페르소나에 주는 근거의 깊이가 응답을 얼마나 바꾸는가? 본조사에 어떤 근거 수준이 적절한가?
- 규모
- 5조건 × 190문항
- 조건
- A 본인 문서 · B 프로파일 카드 · C 통계 클론 · D1·D2 무작위 인물
- 보고서
- 보고서 미수록
핵심 결과 — A 대비 평균 절대 차이가 B 0.19 → C 0.49 → D1 0.61 → D2 0.96으로 예외 없이 단조 증가했다. 프로파일 카드로 문서 수준 응답의 대부분을 재현하지만 가치 트레이드오프는 어느 조건에서도 신뢰할 수 없어, 이것을 본조사 해석의 경계로 삼았다.
보고서 이전 실험 기록(탐색) 출처: 연구 작업 노트(grounding gradient 실행 결과, 비공개)
- 한계
- 기준(A)이 한 사람의 문서
- 정도는 재현되나 방향(입장)은 재현되지 않음
2026-09-02사람 자료 대조완료합성 응답(진단)
2019 → 2026 시계열 (참고)
- 질문
- 2019 미래상 설문과 비교하면 순위와 방향이 어떻게 바뀌었는가?
- 규모
- 2019 패널 조사 대 합성 1차 초기 스냅샷(594명)
- 조건
- 순위·방향만 참고 비교
- 보고서
- 제6장 제3절
핵심 결과 — 순위·방향의 참고 비교로만 썼으며, 합성 자료가 초기 스냅샷이어서 결론 근거로 쓰지 않았다. D-18
- 한계
2026-09-07본조사완료합성 응답(진단)
본조사: 1,000명 × 190문항 × 3회
- 질문
- 여섯 미래상에 대해 합성 페르소나는 어떤 기대·우려·조건을 보이는가? 세 차례 다시 물으면 같은가?
- 규모
- 1,000명 × 3회 = 3,000응답
- 조건
- 미래상 심층 모듈 순서만 차수마다 달리함 · 도전과제 25개는 페르소나마다 순서 무작위 · 형식 점검 통과분만 저장
- 모델
- Claude Opus 계열(3차는 전원 같은 설정)
- 보고서
- 제2·3·5장
핵심 결과 — 3,000응답을 모두 수집했고 탈락 0, 누락·중복 페르소나 0명. 수용도 순위는 ⑥포용(4.72) > ③에너지 > ②초장수 > ⑤룰메이커 > ④생활권 확장 > ①지능강국(2.77)이며 세 차례 같았다. D-1 D-2 D-9
- 한계
- 차수별 모델 설정이 완전히 같지 않음(1차 일부 243명 다른 모델, 2차 218건 출처 미해결)
- 미래상 심층 모듈 순서의 효과와 차수·시점의 효과를 떼어 볼 수 없음
- 여론조사가 아님
2026-09-07통제군·M-arm·레드팀완료합성 응답(진단)
조건 비교 (같은 순서 재질문 50명)
- 질문
- 같은 50명에게 1차와 같은 순서로 다시 물으면 결과가 얼마나 흔들리는가?
- 규모
- 50명
- 조건
- 1차와 같은 제시 순서 · 컨텍스트 설정은 본조사와 다름
- 보고서
- 제1장 제7절, 부록 A-2
핵심 결과 — 컨텍스트 설정이 본조사와 달라 같은 조건의 반복이 아닌 민감도 자료로만 썼다. D-2
- 한계
2026-09-07통제군·M-arm·레드팀완료합성 응답(진단)
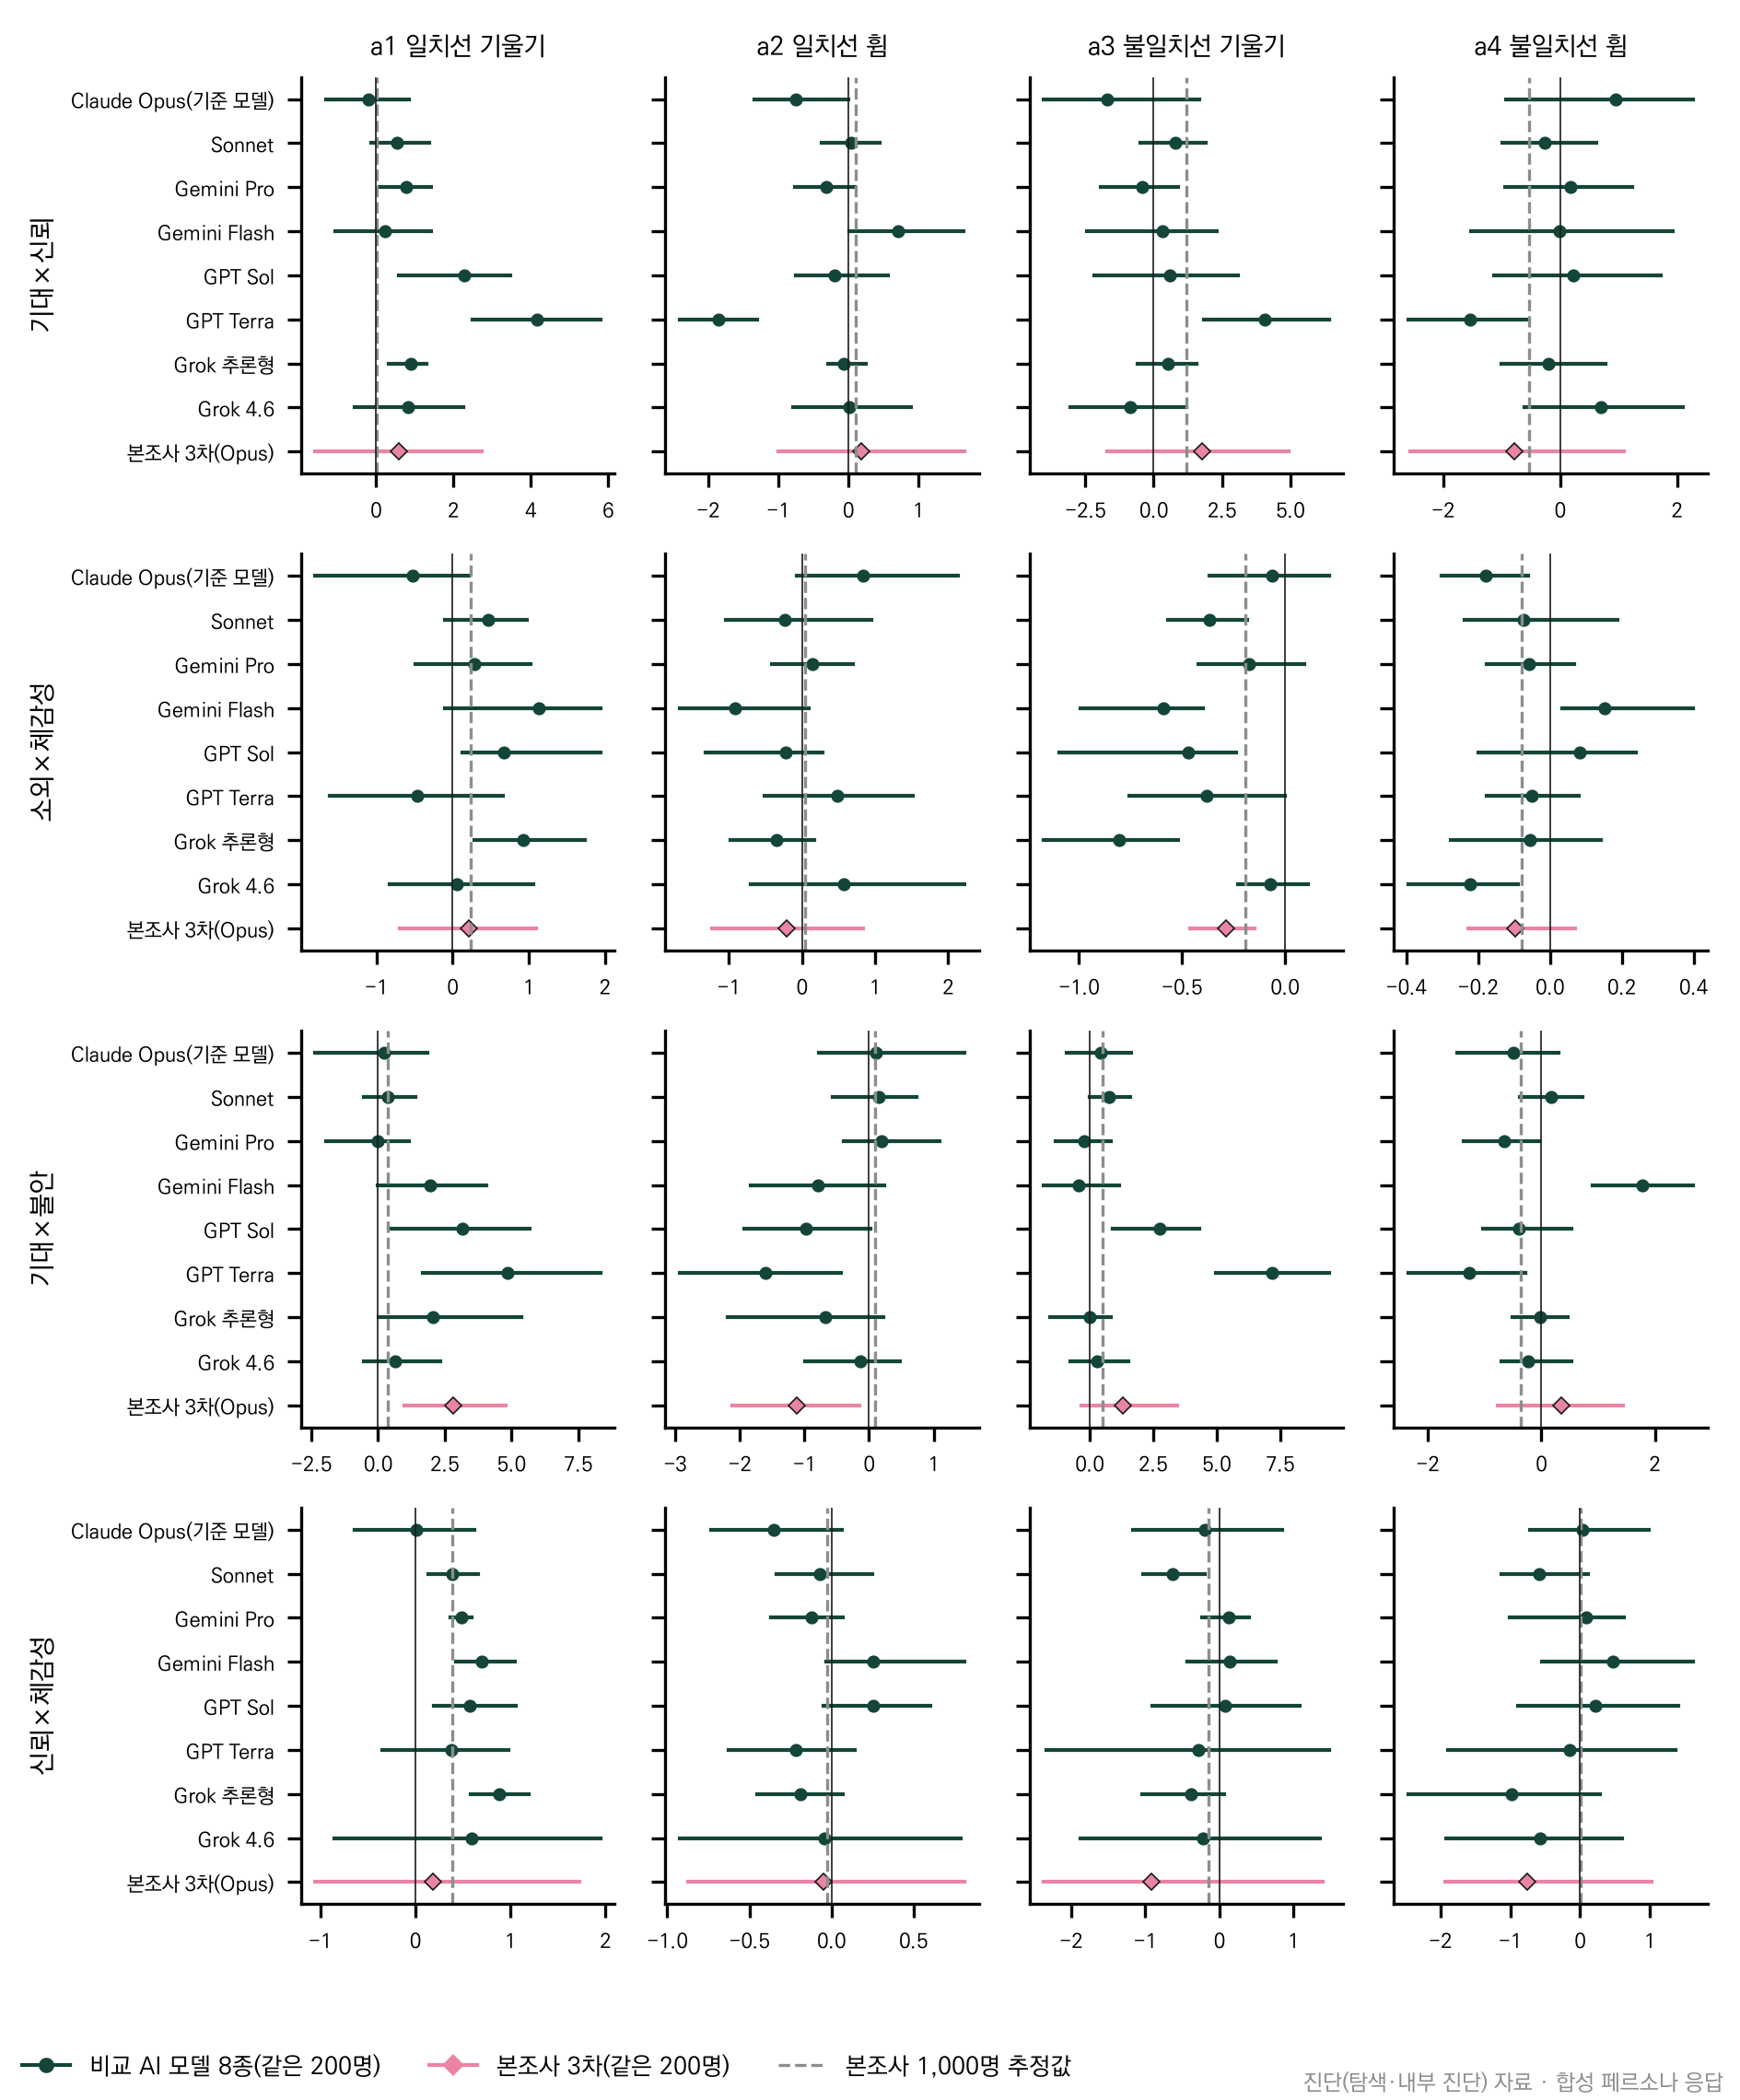
모델 다양성 암(M-arm): 8개 AI 모델
- 질문
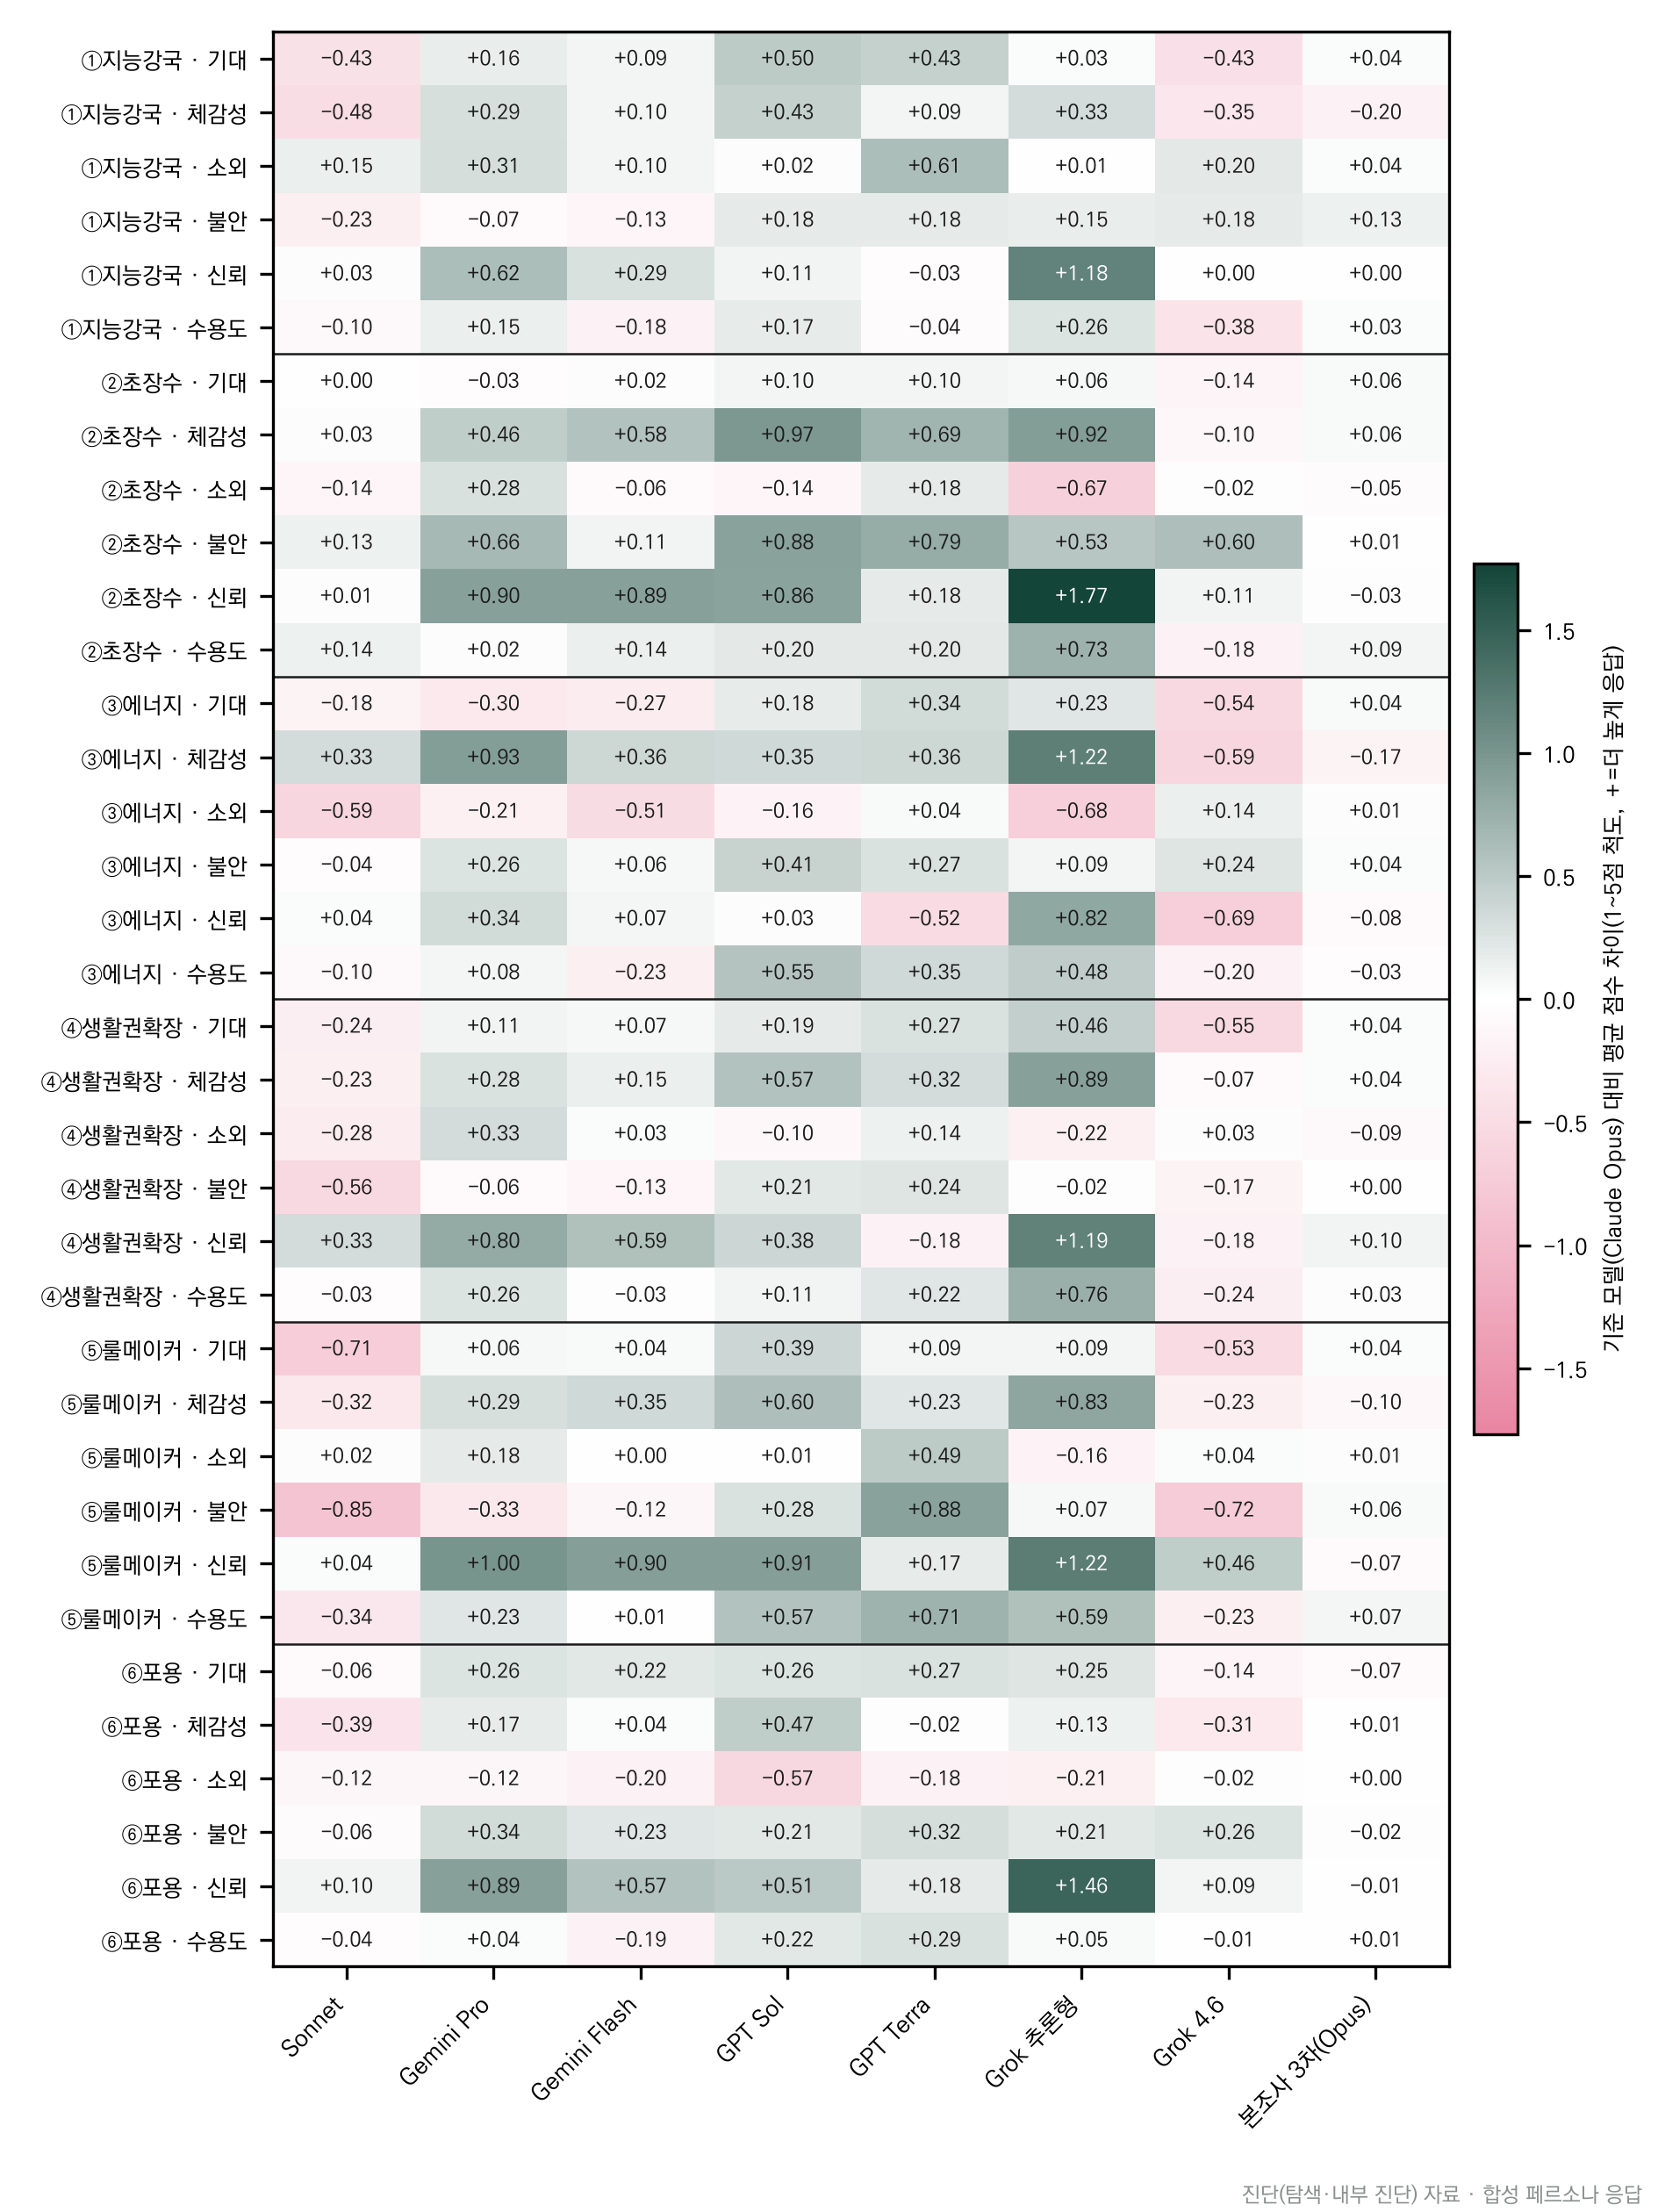
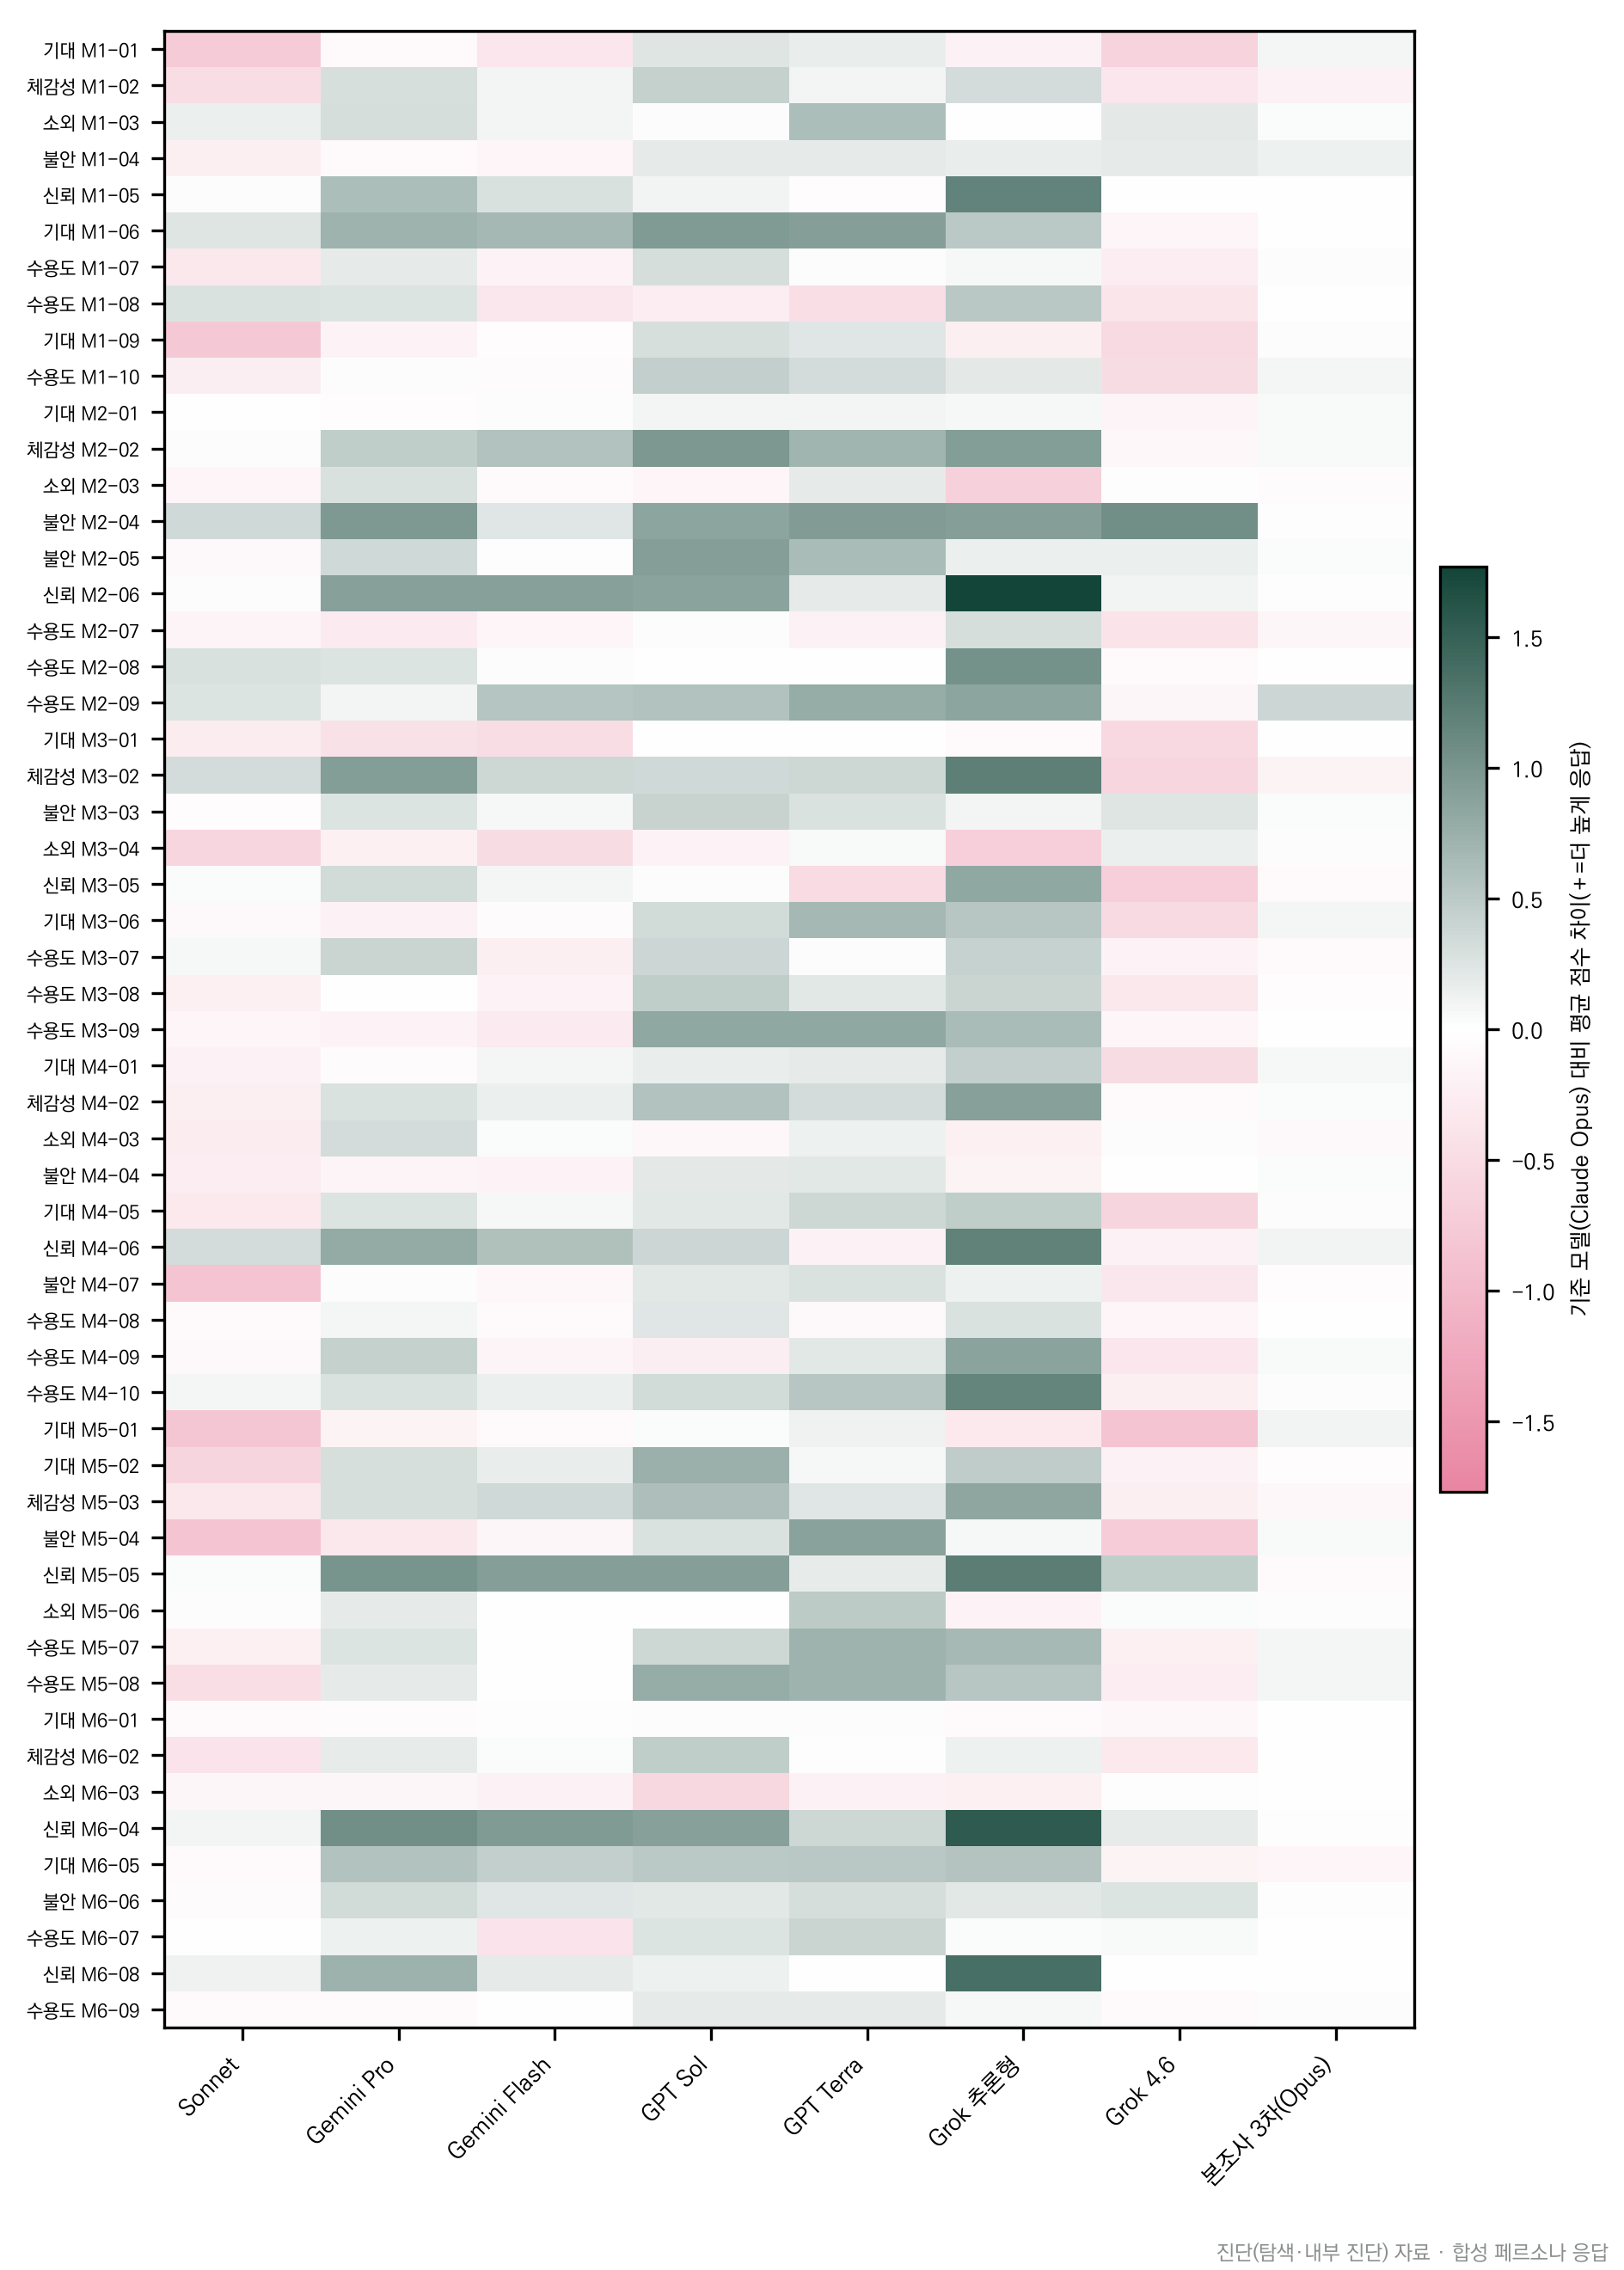
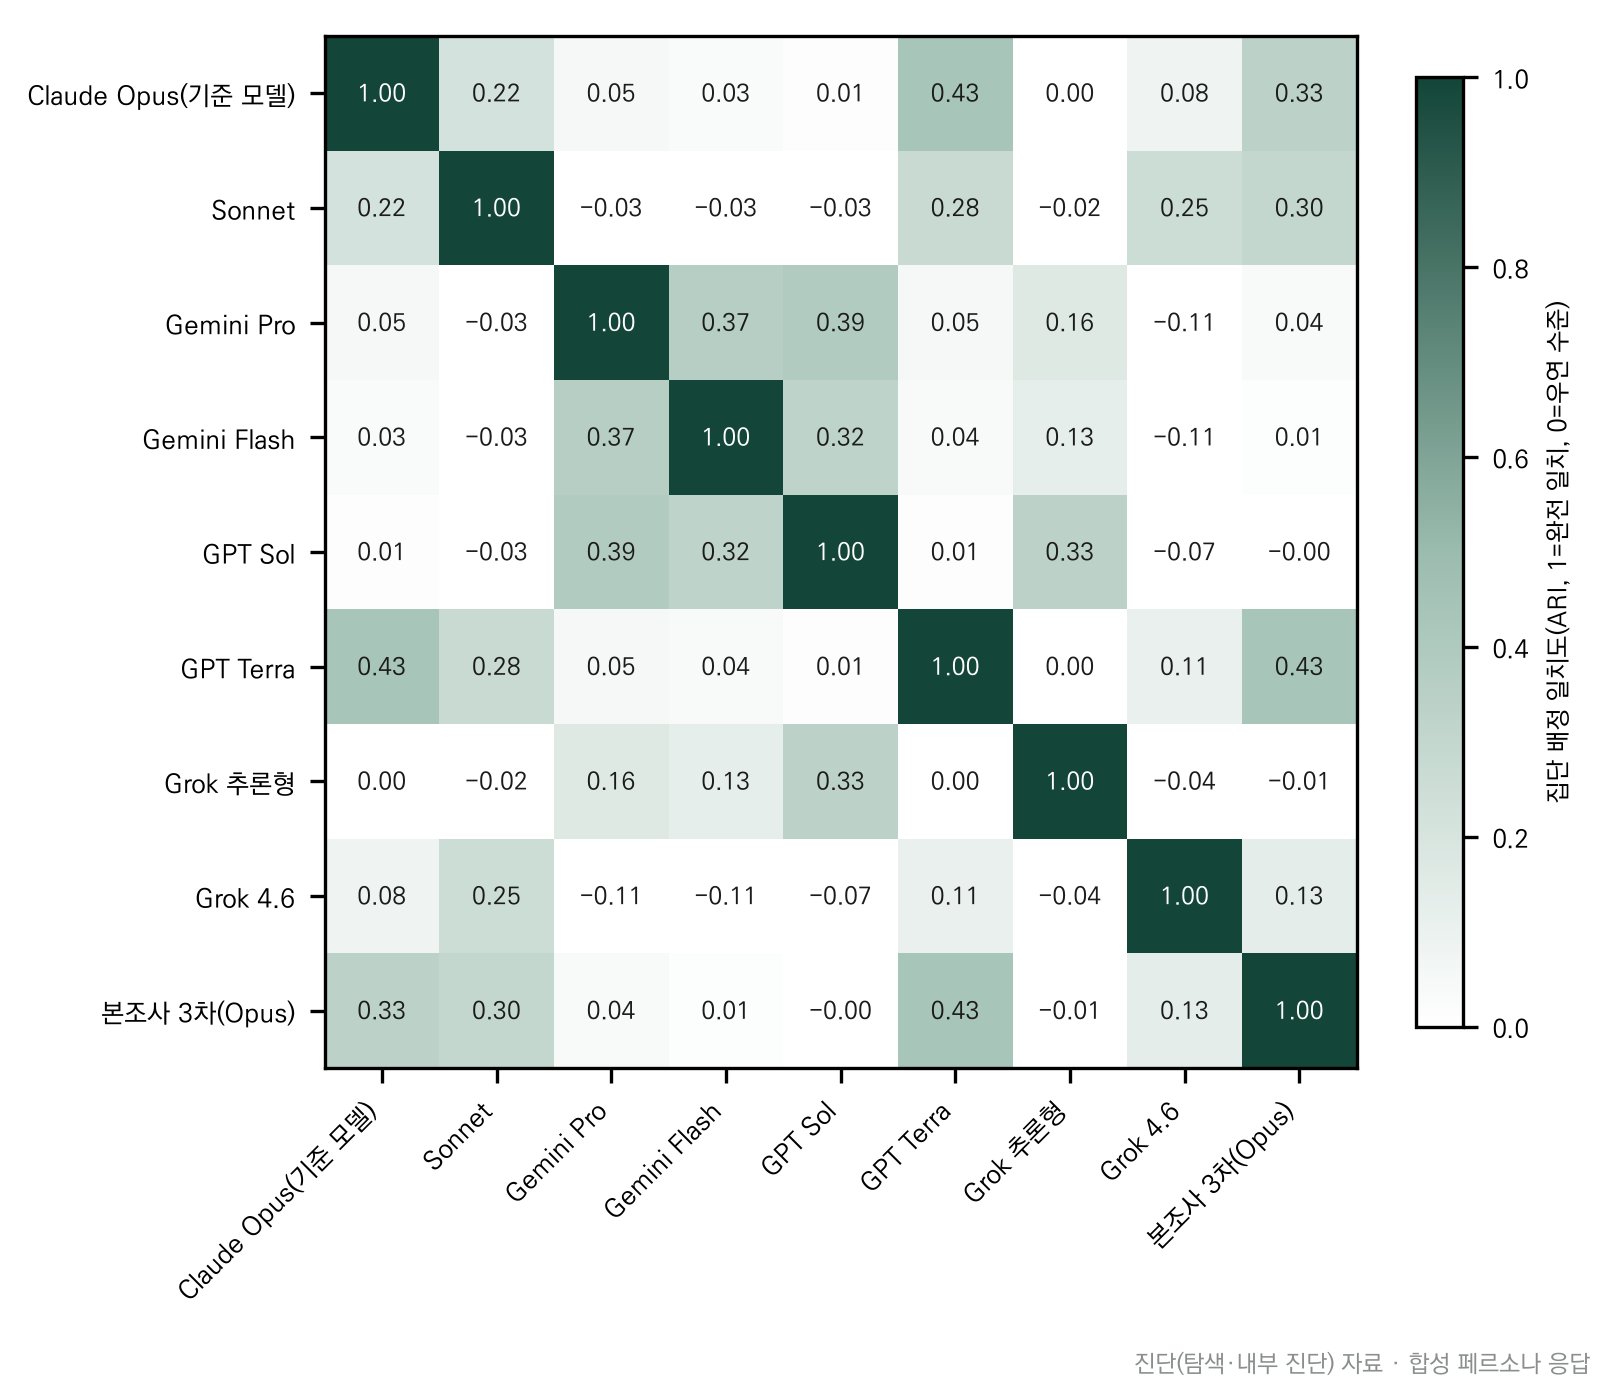
- 응답 모델을 바꾸면 미래상 순위와 개인의 답이 유지되는가?
- 규모
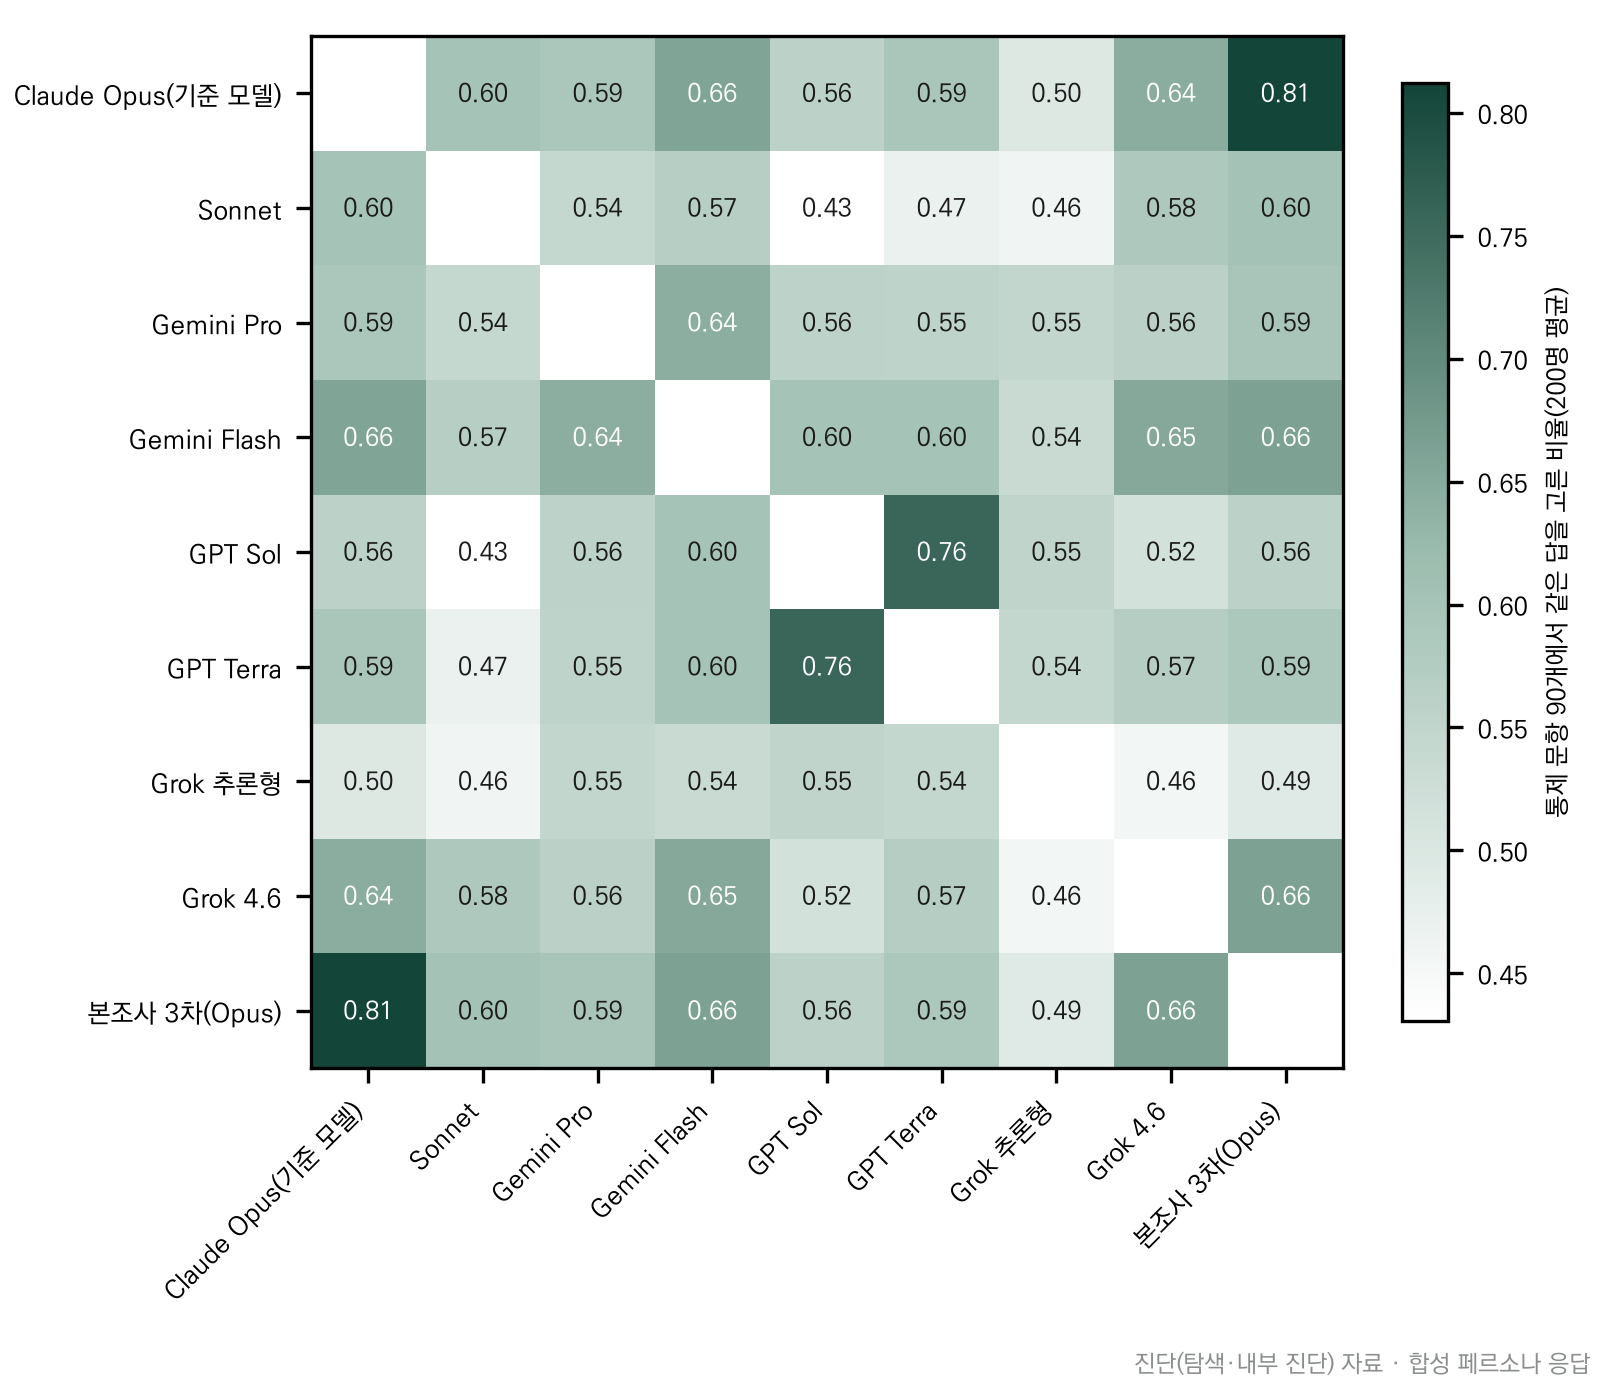
- 같은 200명 × 8모델 = 1,600응답
- 조건
- 같은 문항·제시문·순서 · 통제 문항 90개로 개인 답 비교
- 모델
- Claude Opus (기준), Claude Sonnet, GPT Sol, GPT Terra, Gemini Pro, Gemini Flash, Grok 추론형, Grok 4.6
- 보고서
- 제5장 제8절
핵심 결과 — 미래상 순위 일치도(Kendall W)는 .941로 ⑥포용·③에너지·①지능강국이 각각 1·2·6위로 같았다. 반면 개인 답의 정확한 일치율은 기준 모델과 나머지 모델 사이 49.6~65.7%에 그쳤다. D-5
- 한계
- 모든 모델이 같은 제시문을 읽어 제시문의 영향과 분리되지 않음
- 모델 간 차이에 프롬프트 전달 형식 차이가 섞임
- 9/10 코드 보완 뒤 재계산하지 않은 저장본
2026-09-09분석완료합성 응답(진단)
반복 일치도 (같은 모델 계열 757명)
- 질문
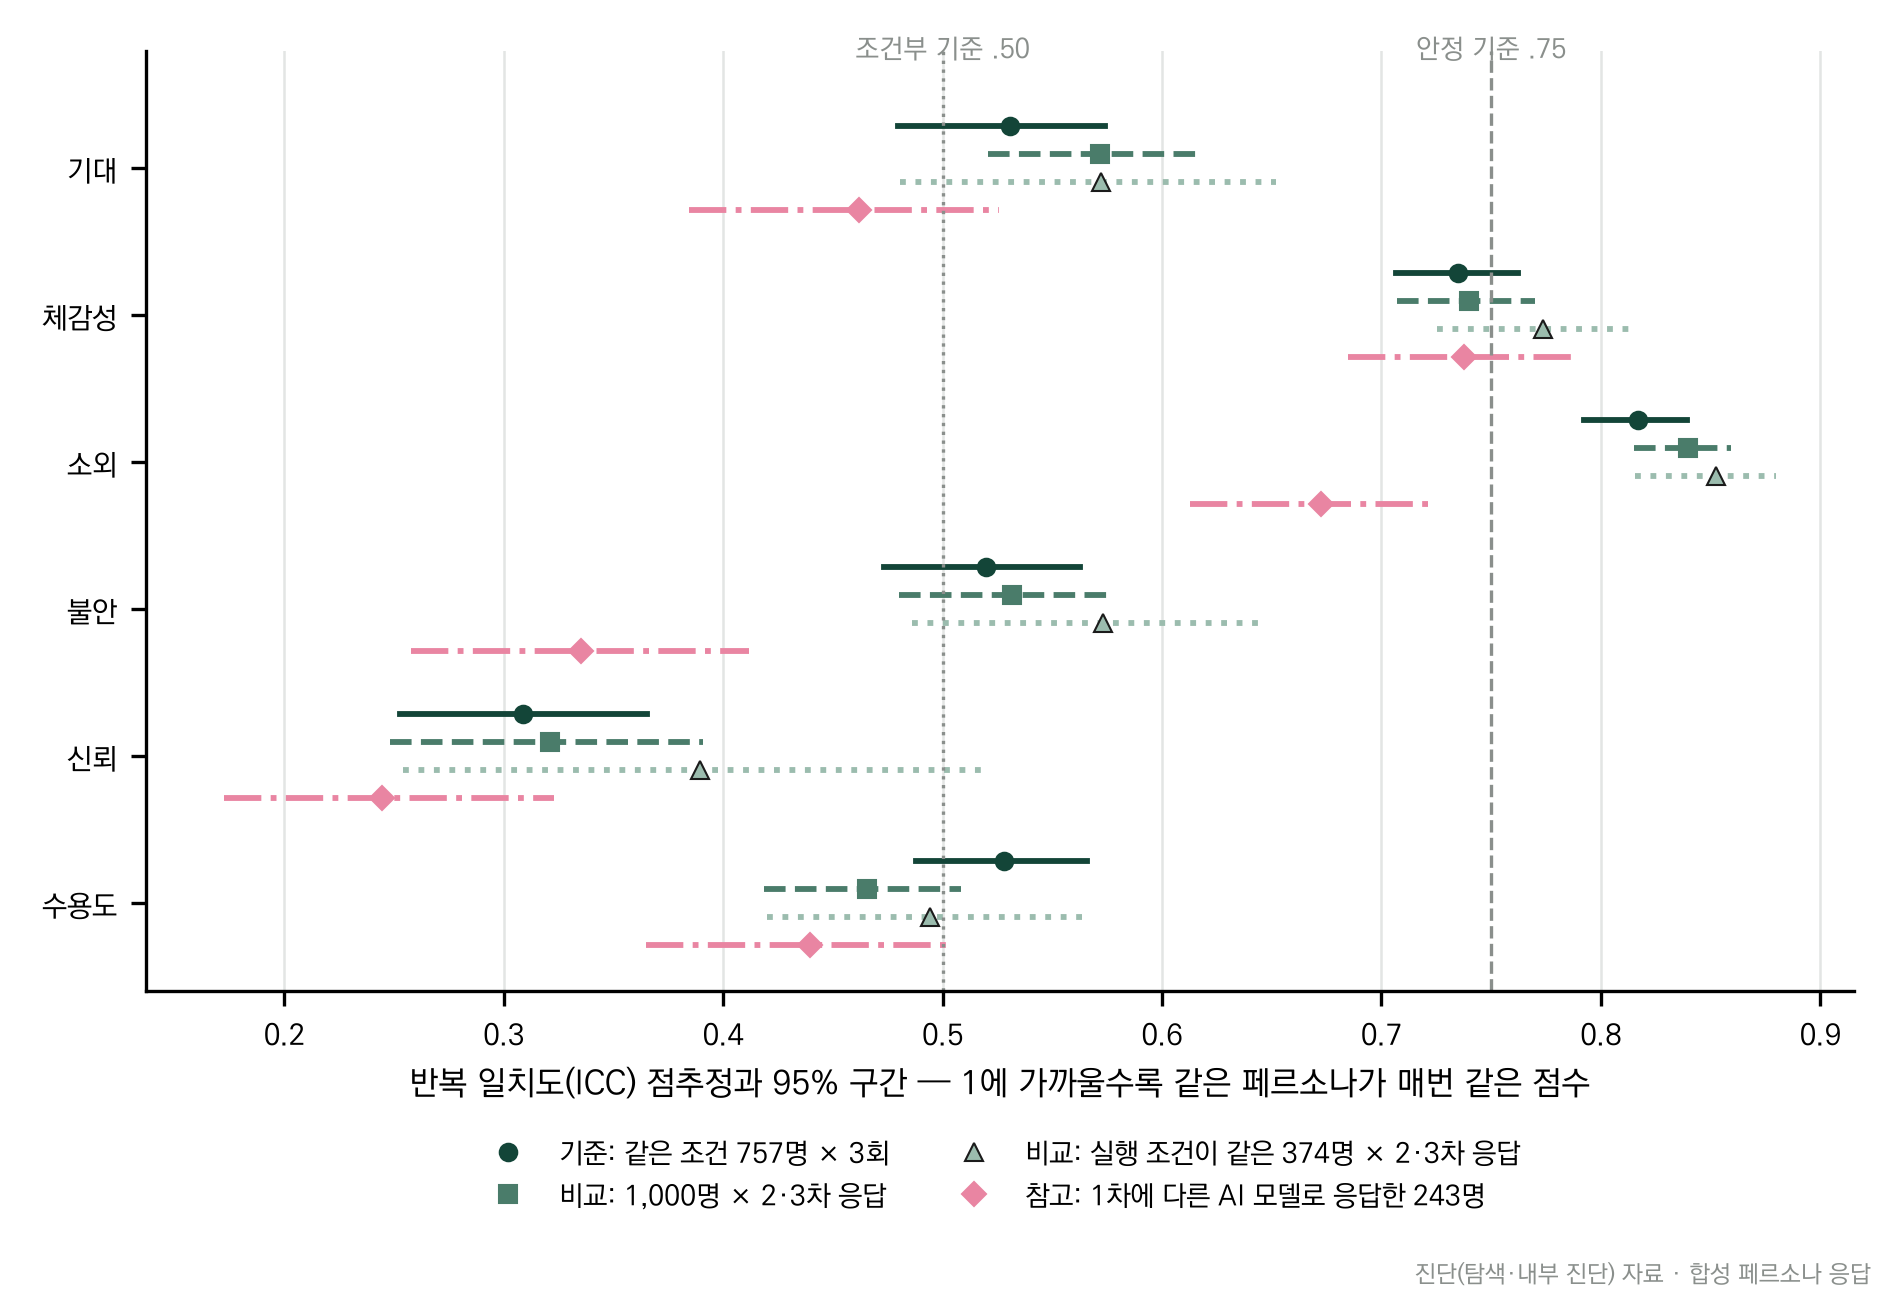
- 같은 페르소나가 세 차례 같은 축 점수를 내는가?
- 규모
- 757명 × 3회
- 조건
- ICC(2,1)과 95% 부트스트랩 구간 · 판정선 .75 안정 · .50 조건부를 자료 전에 확정
- 모델
- Claude Opus 계열
- 보고서
- 제4장
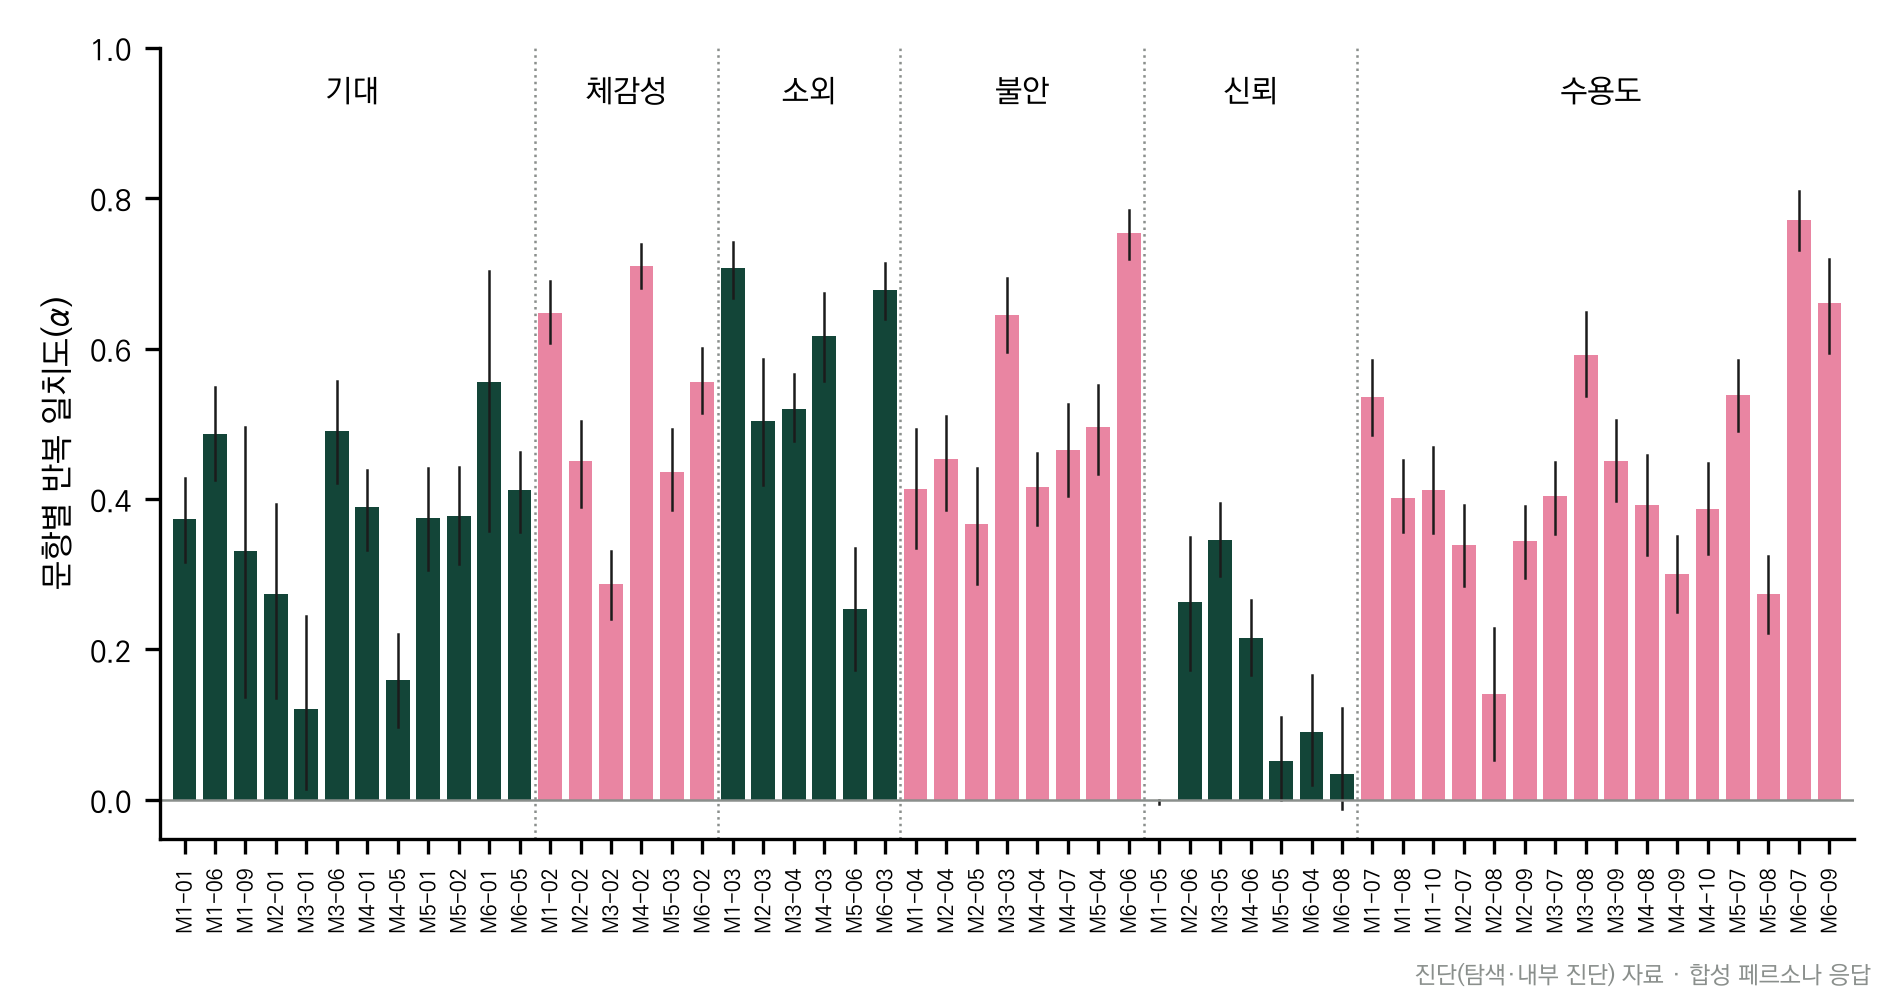
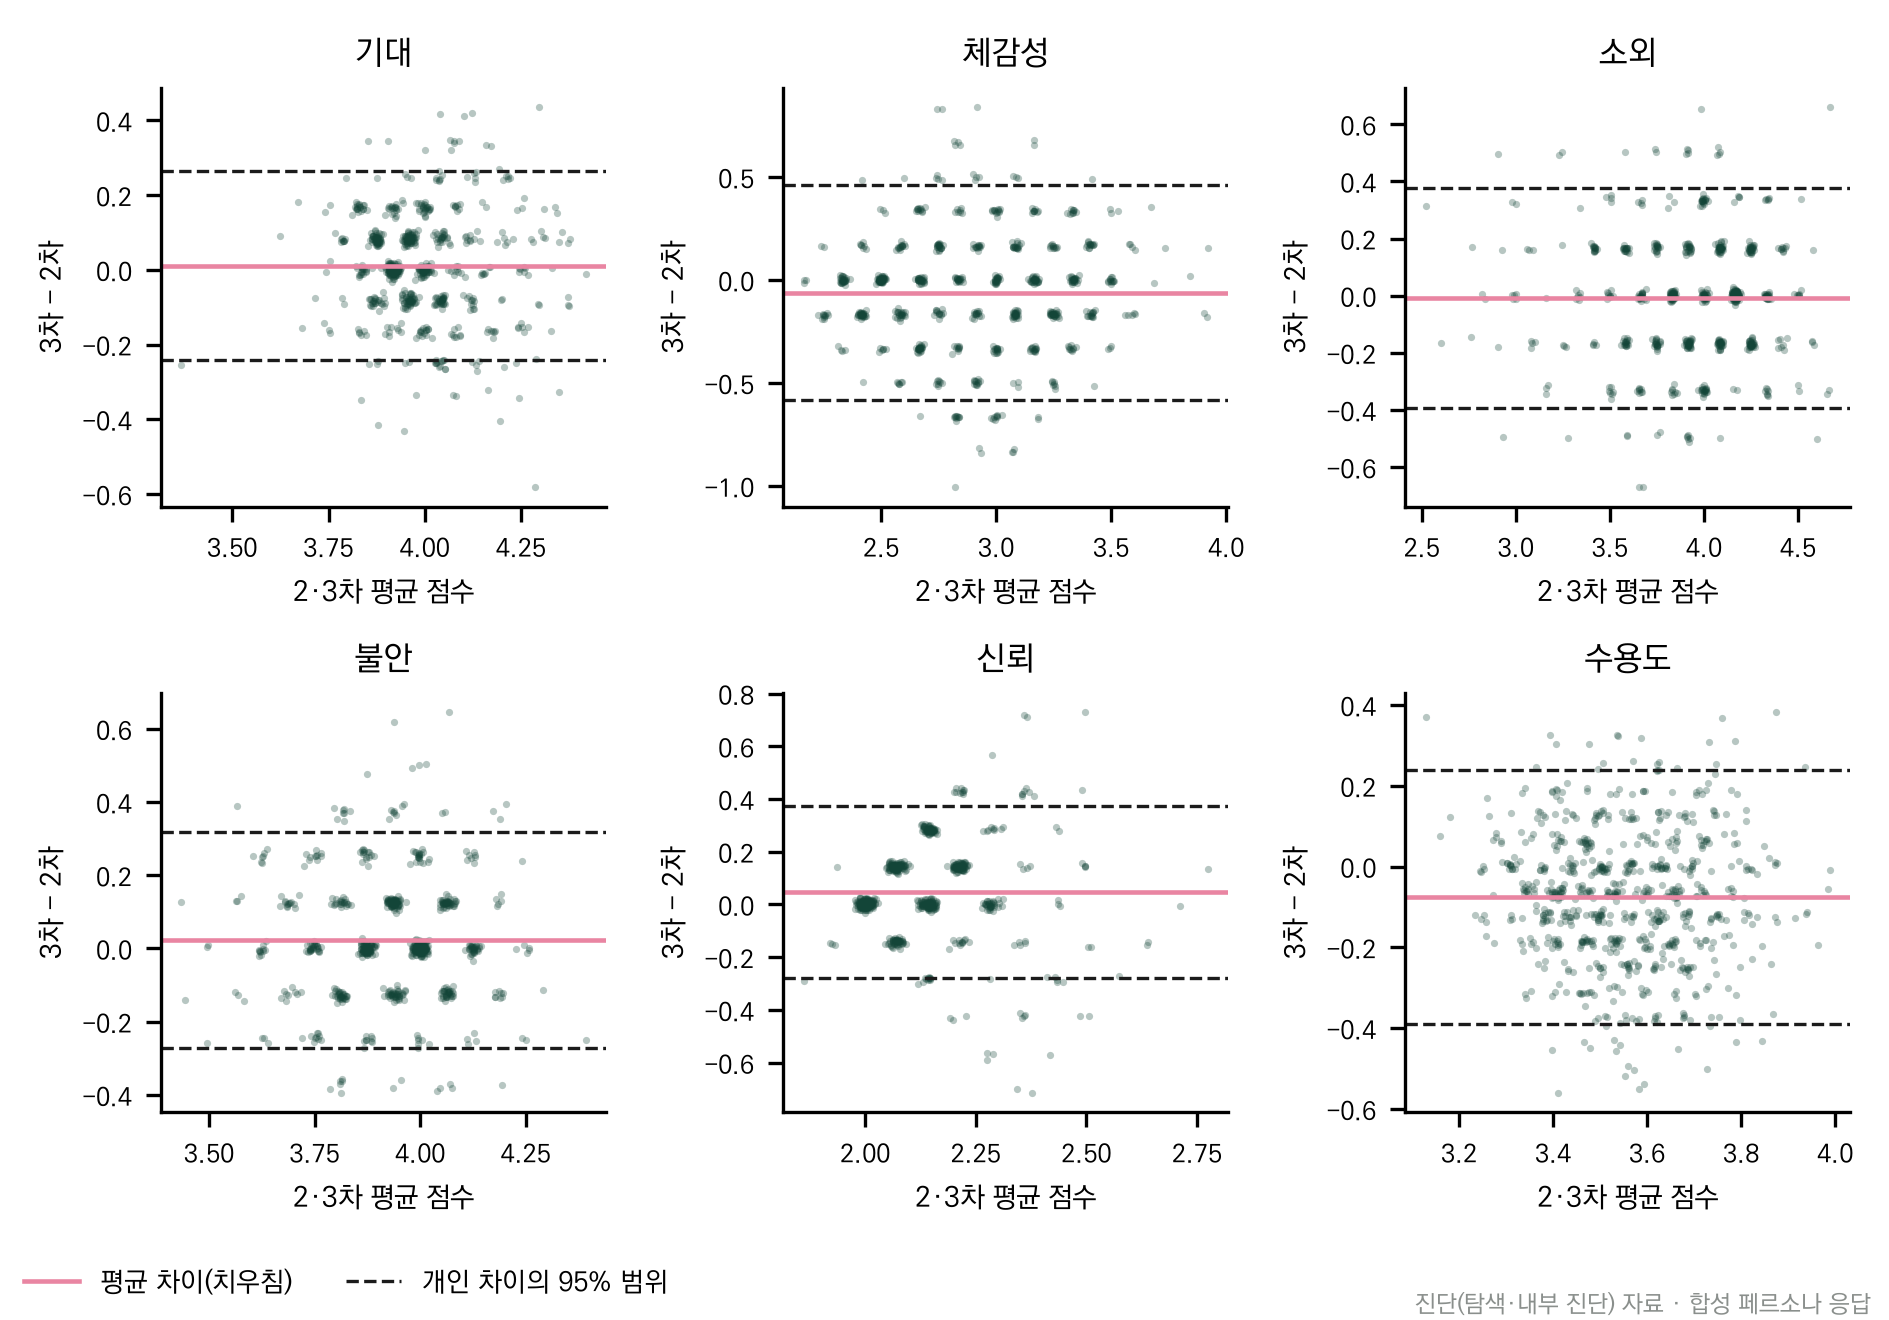
핵심 결과 — 안정은 소외(.817) 한 축뿐이고, 기대(.531)·체감성(.735)·불안(.520)·수용도(.528)는 조건부, 신뢰(.309)는 불안정이었다. 신뢰 축은 개인 단위 해석에서 제외했다. D-7 D-10
- 한계
- 합성 응답 내부의 재현 정도이며 사람 태도의 안정성이나 측정 타당성이 아님
- 정식 판정은 수행하지 않은 참고 판정
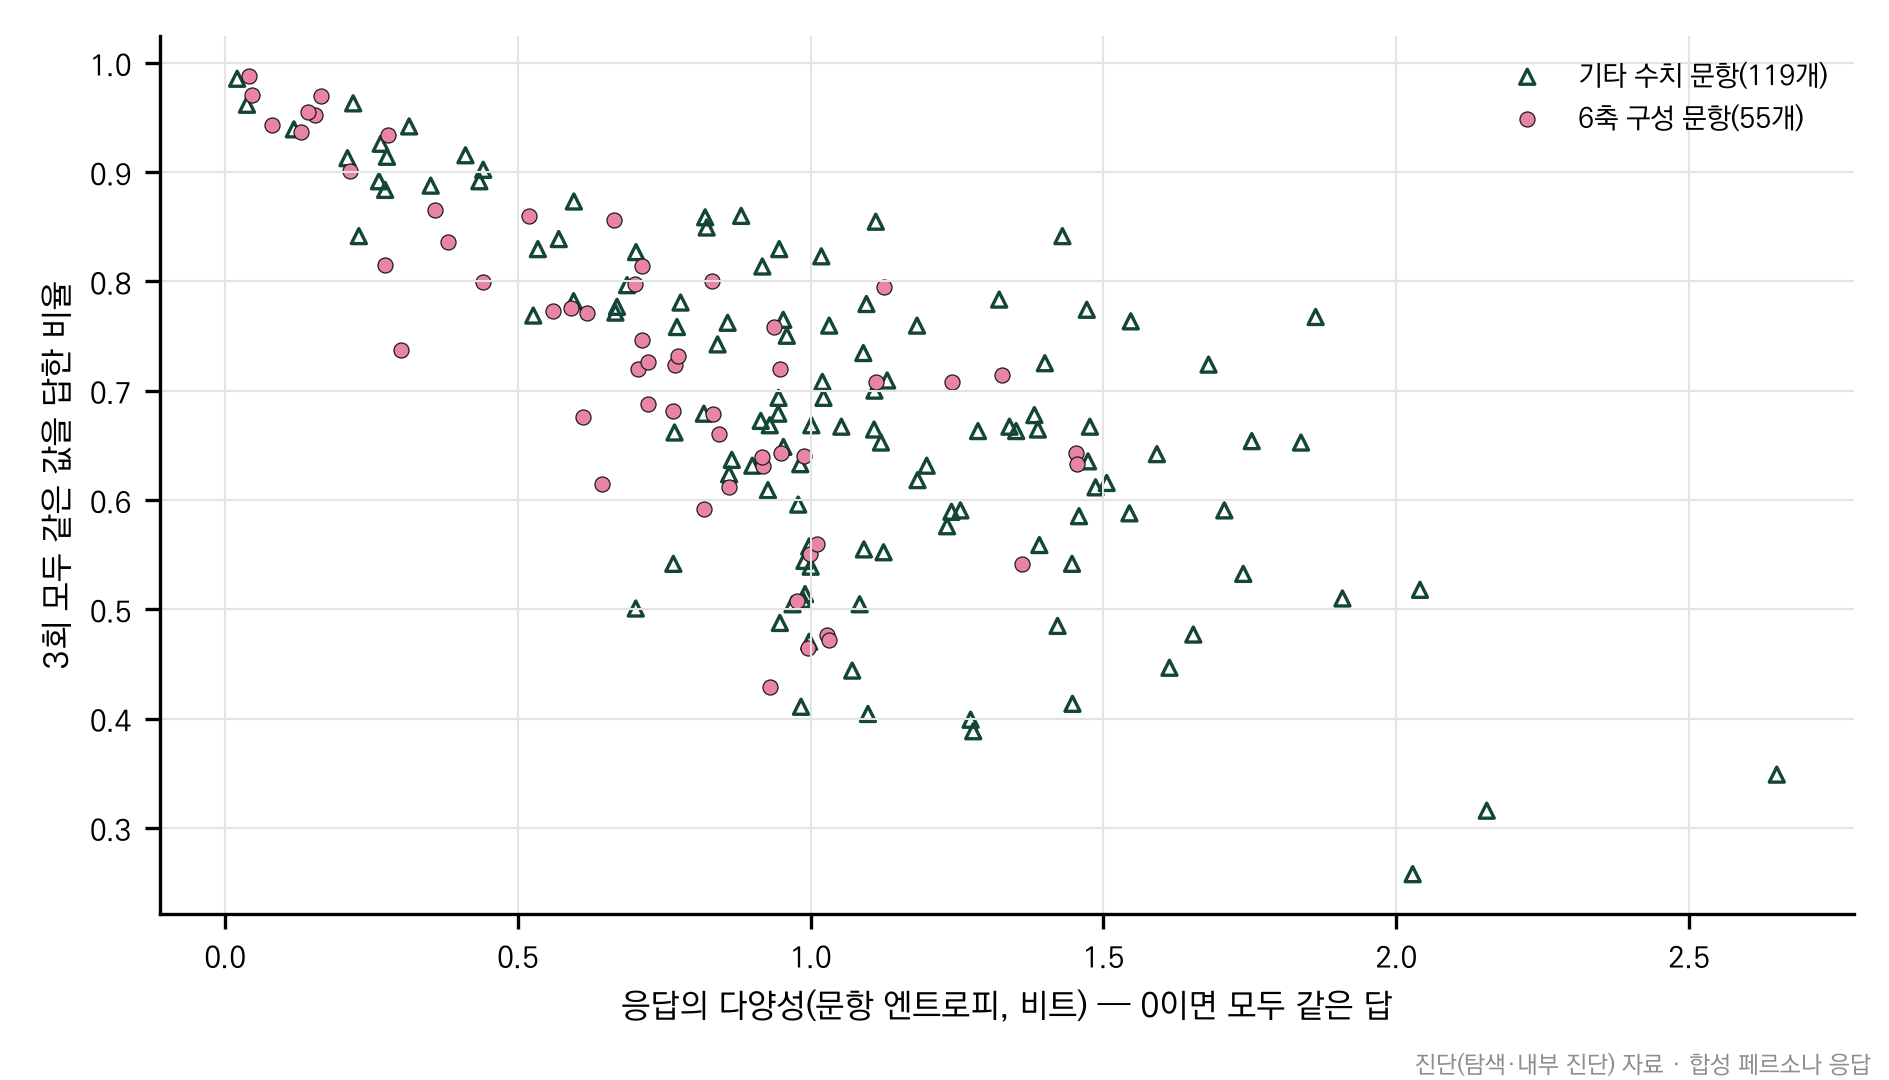
- 6축 구성 문항은 평균 73.0%가 3회 모두 같은 값이어서 높은 일치의 일부는 응답 쏠림일 수 있음
2026-09-11사람 자료 대조완료합성 응답(진단)
대국민 온라인 설문 개방형 대조
- 질문
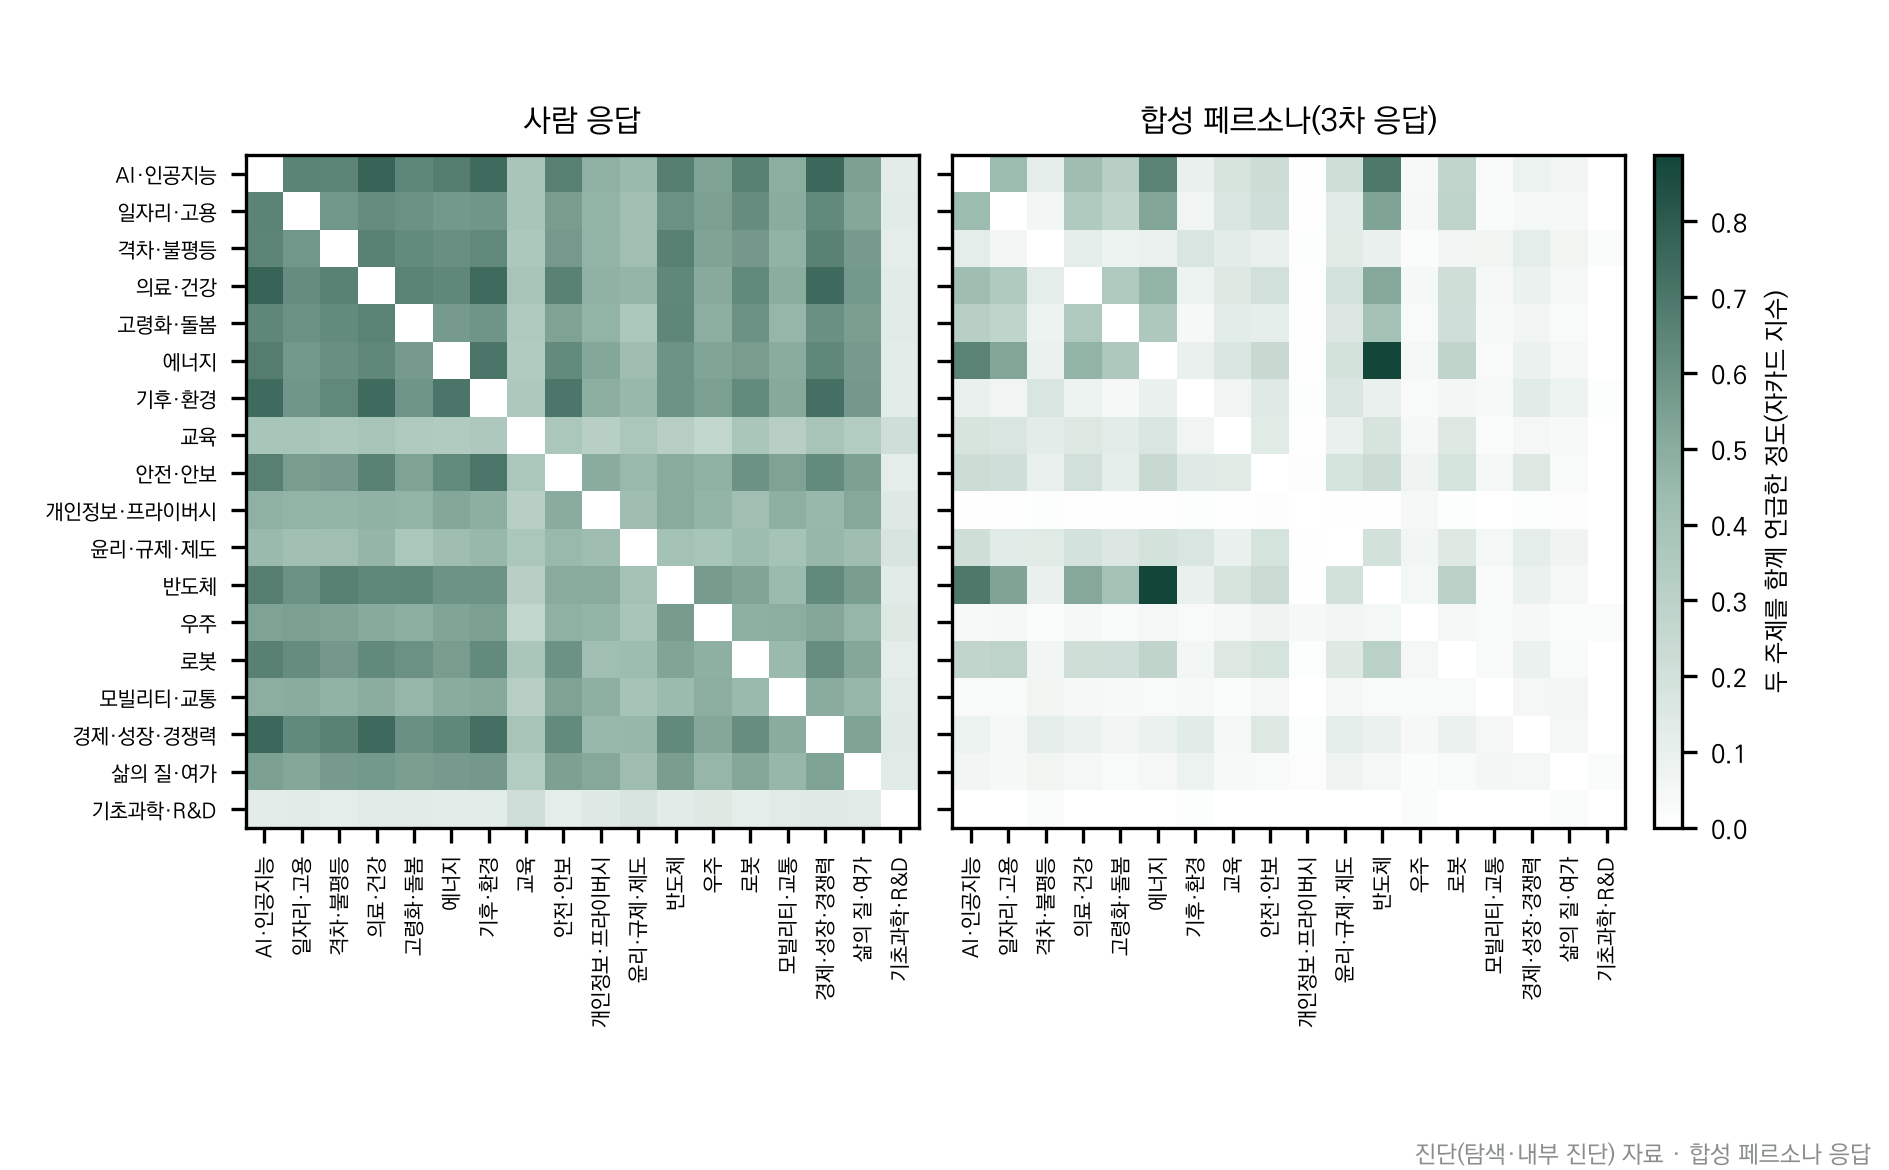
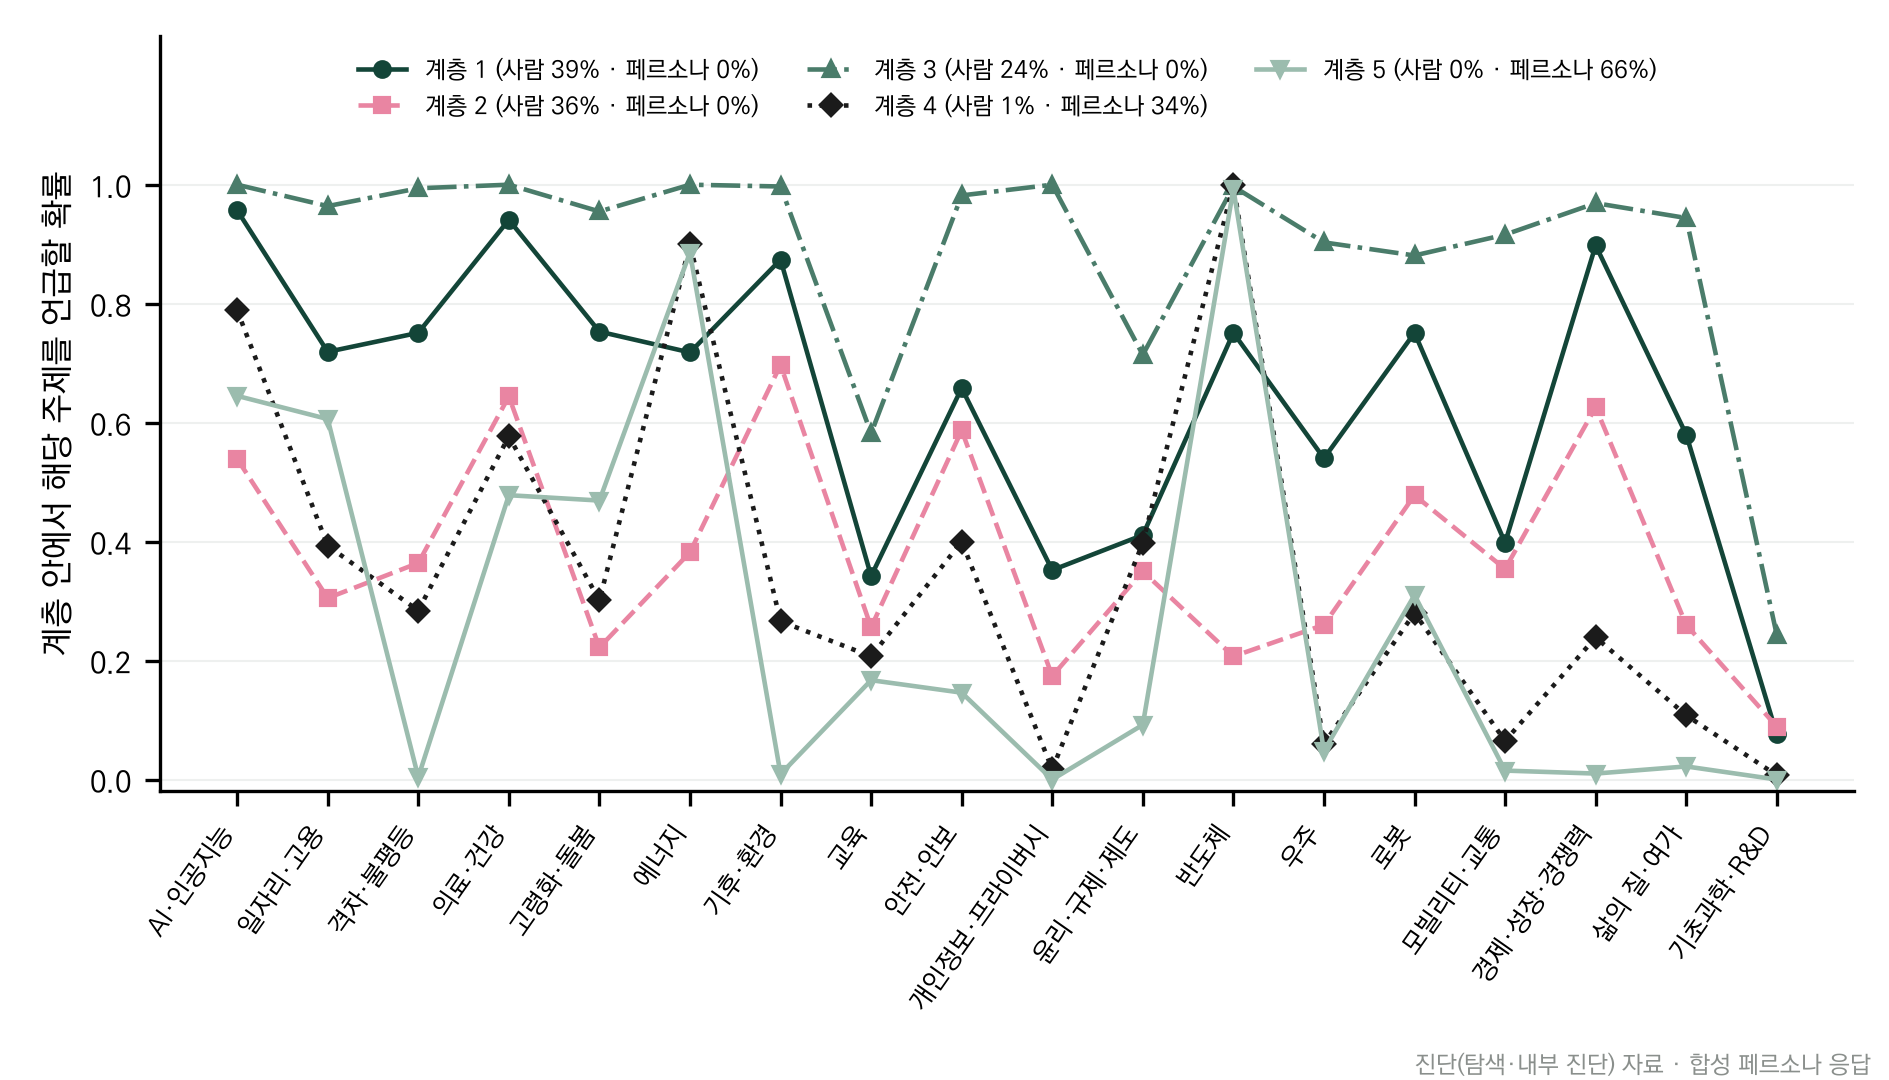
- 같은 개방형 문항에 사람과 합성 페르소나는 어떤 주제를 얼마나 언급하는가?
- 규모
- 사람 573명(1,292명 중 기준 통과) 대 합성 855건
- 조건
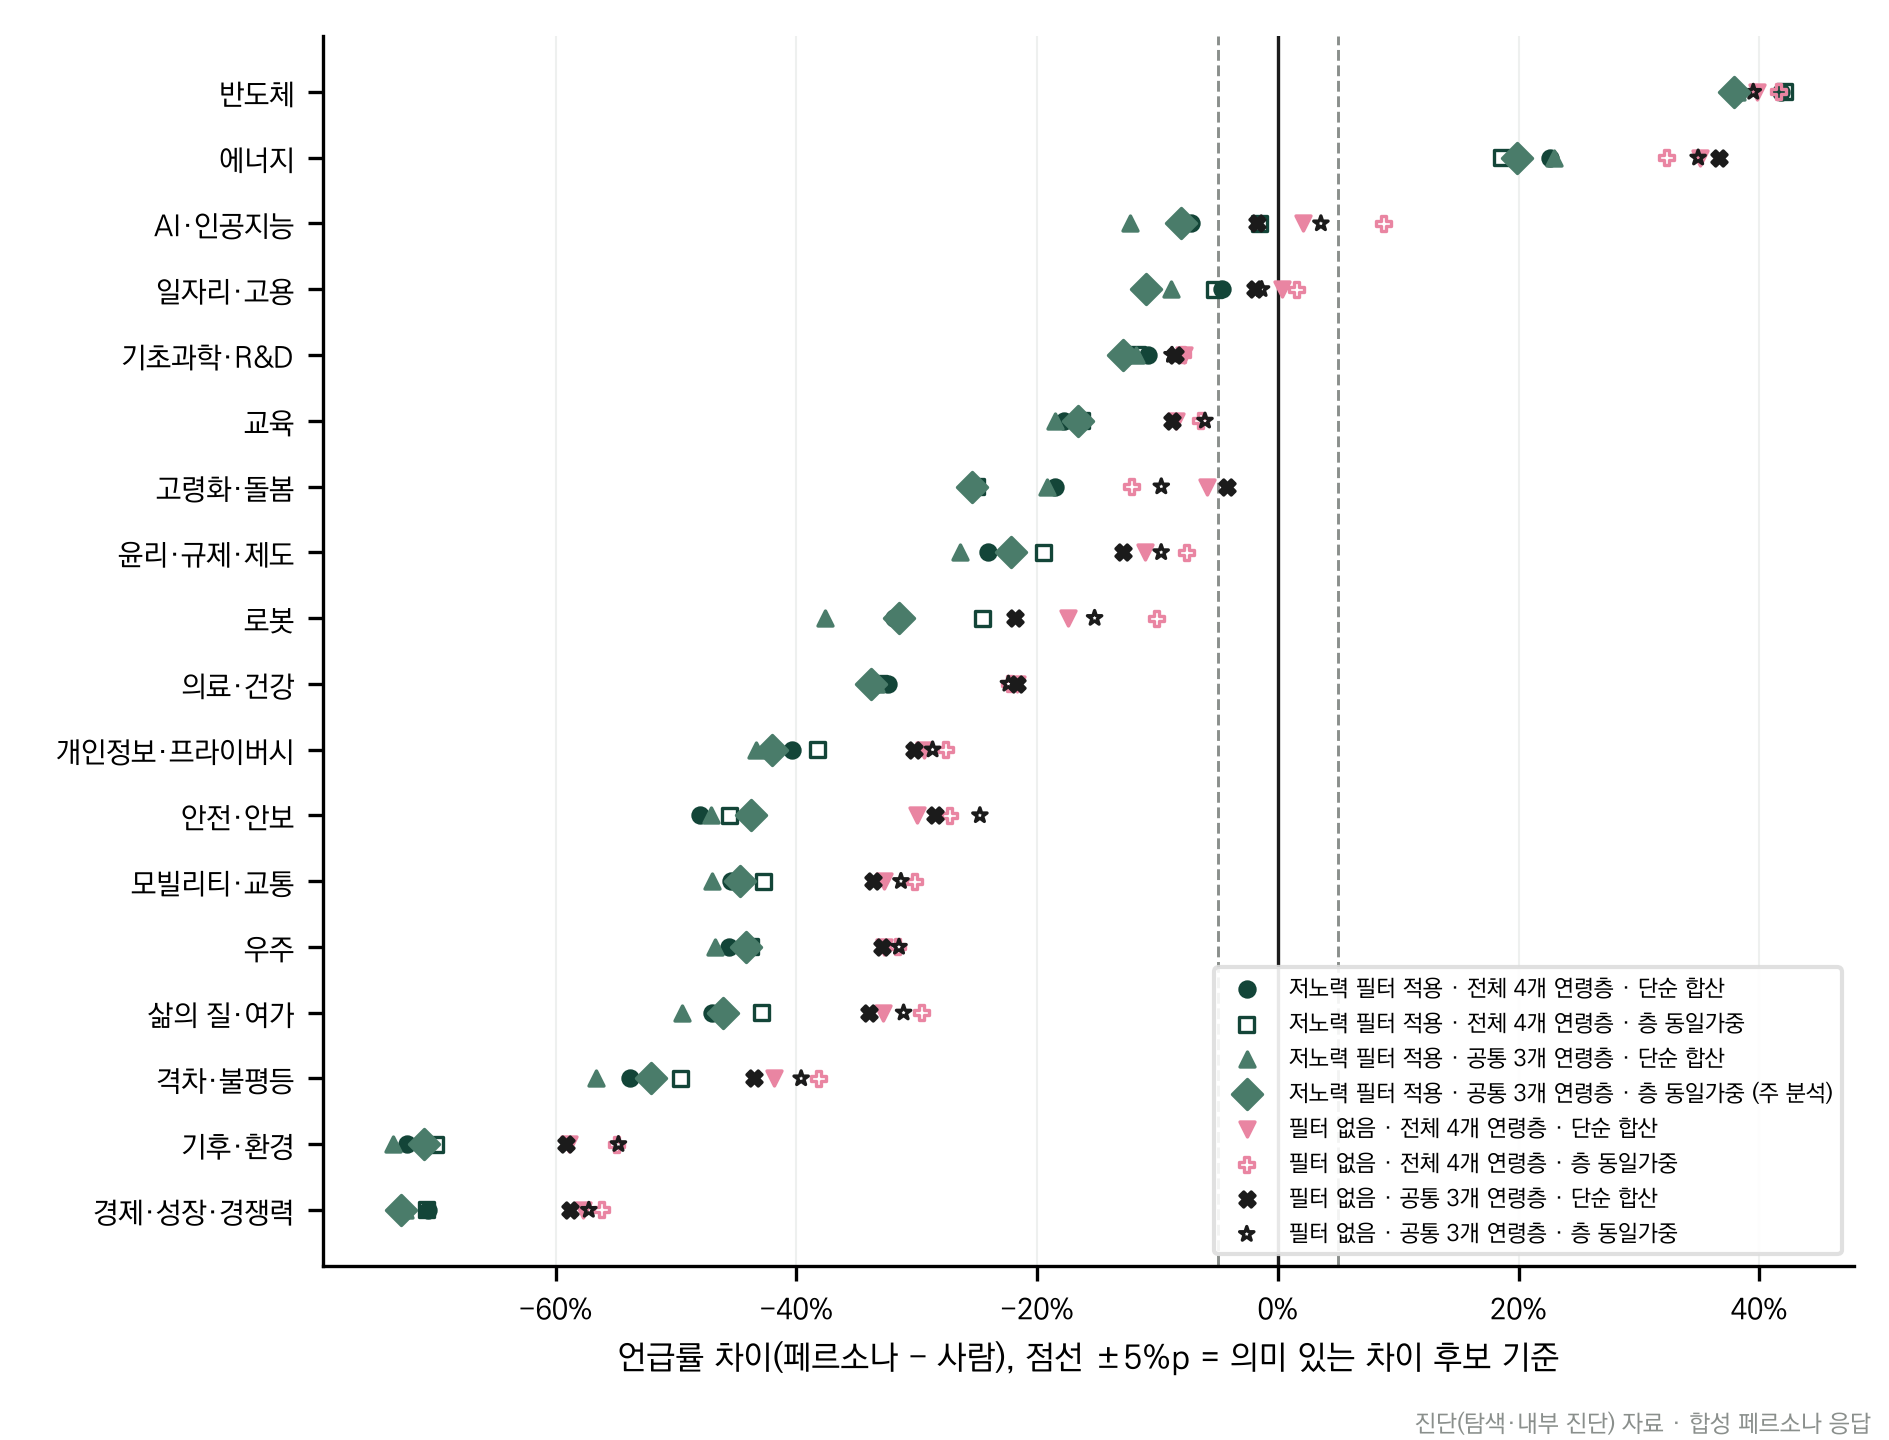
- 공통 연령·성 집단 · 개인 연결 없이 집단끼리 비교 · 18개 주제 사전
- 보고서
- 제6장 제1·2절
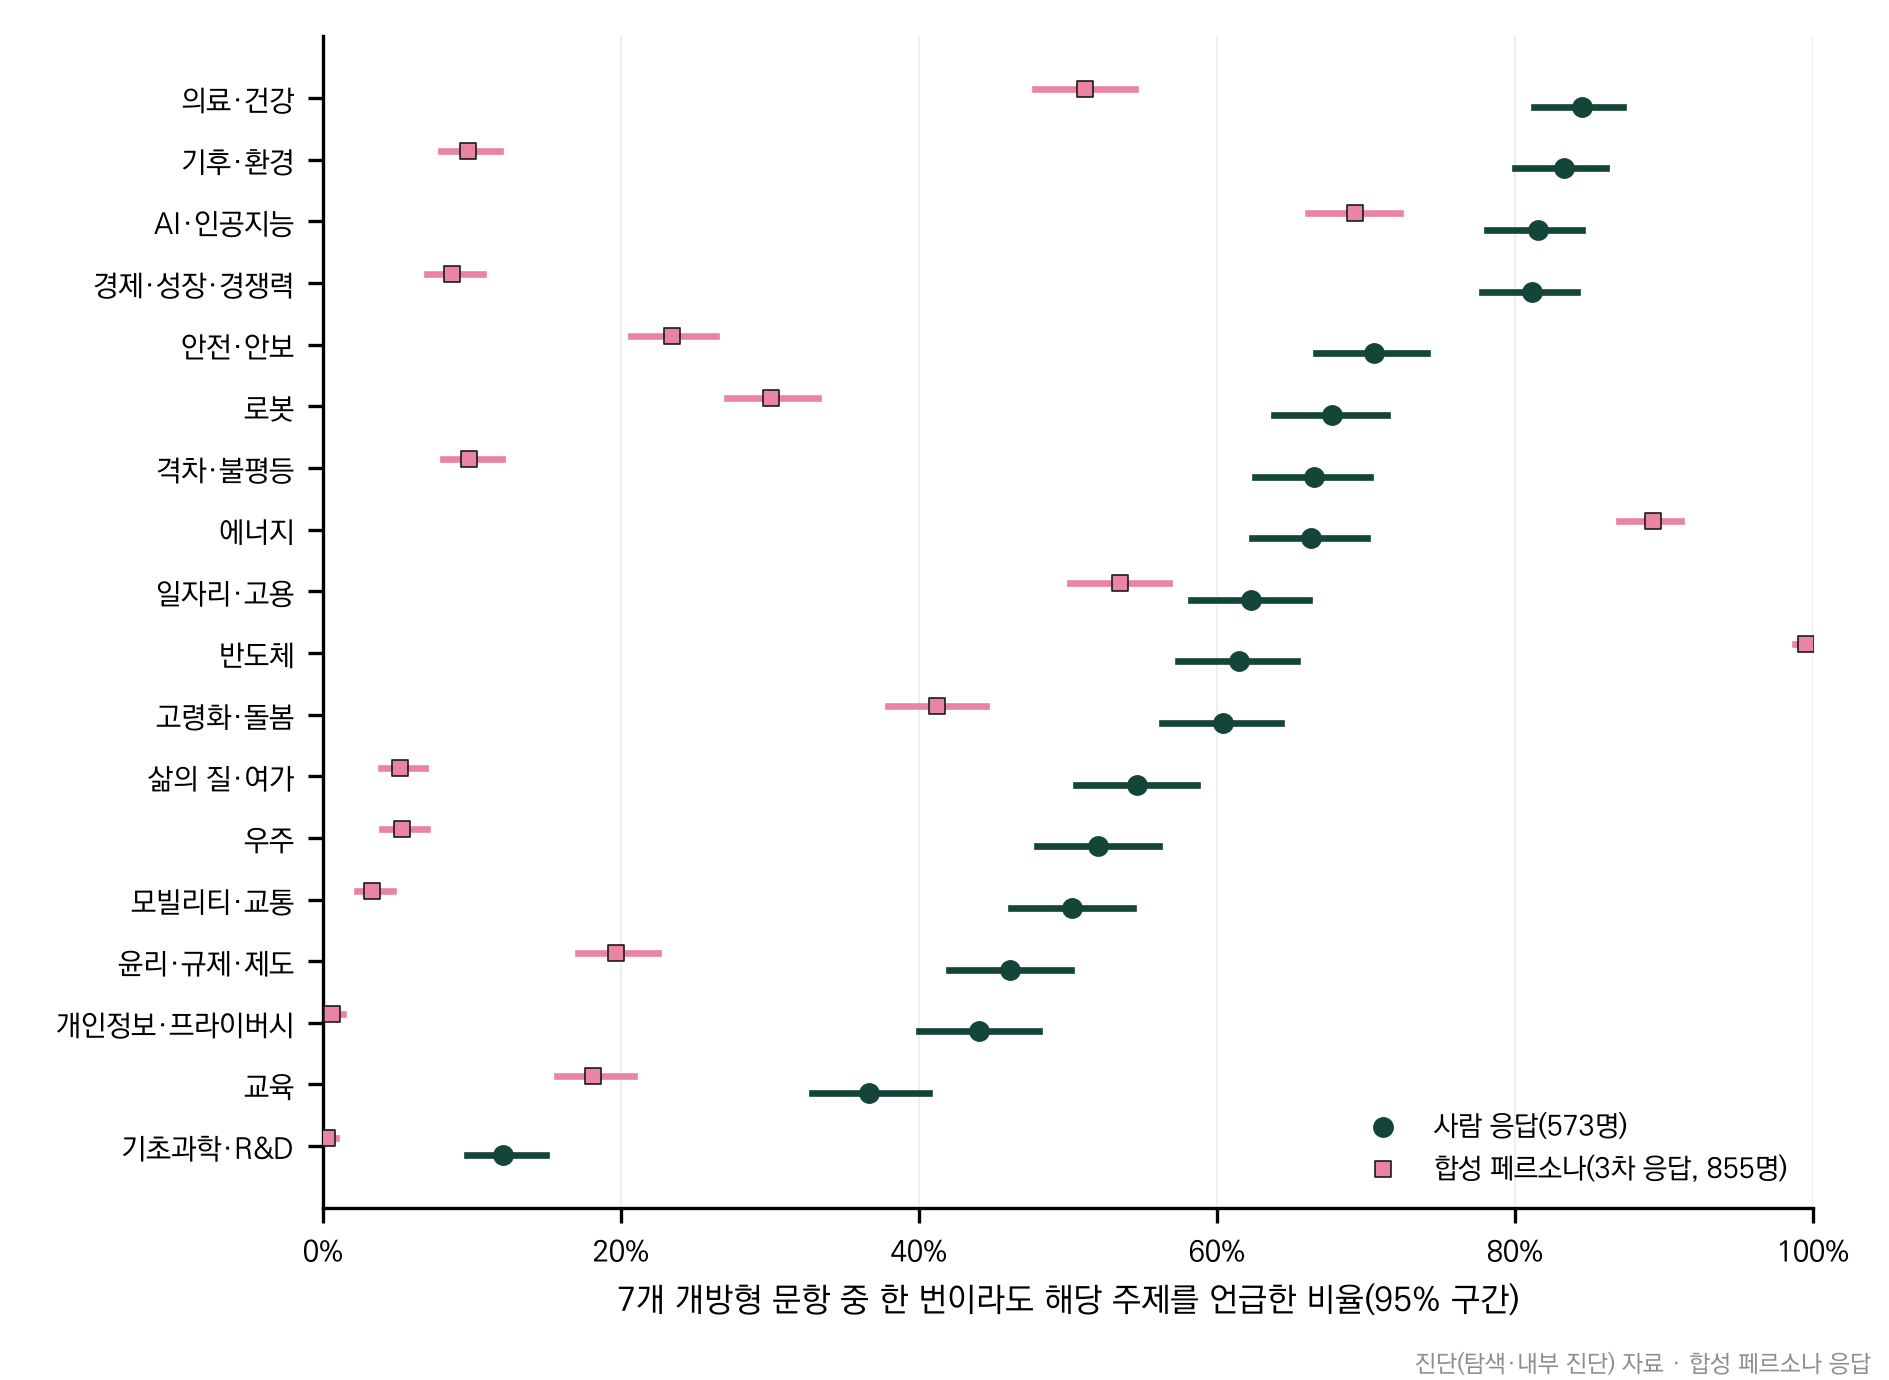
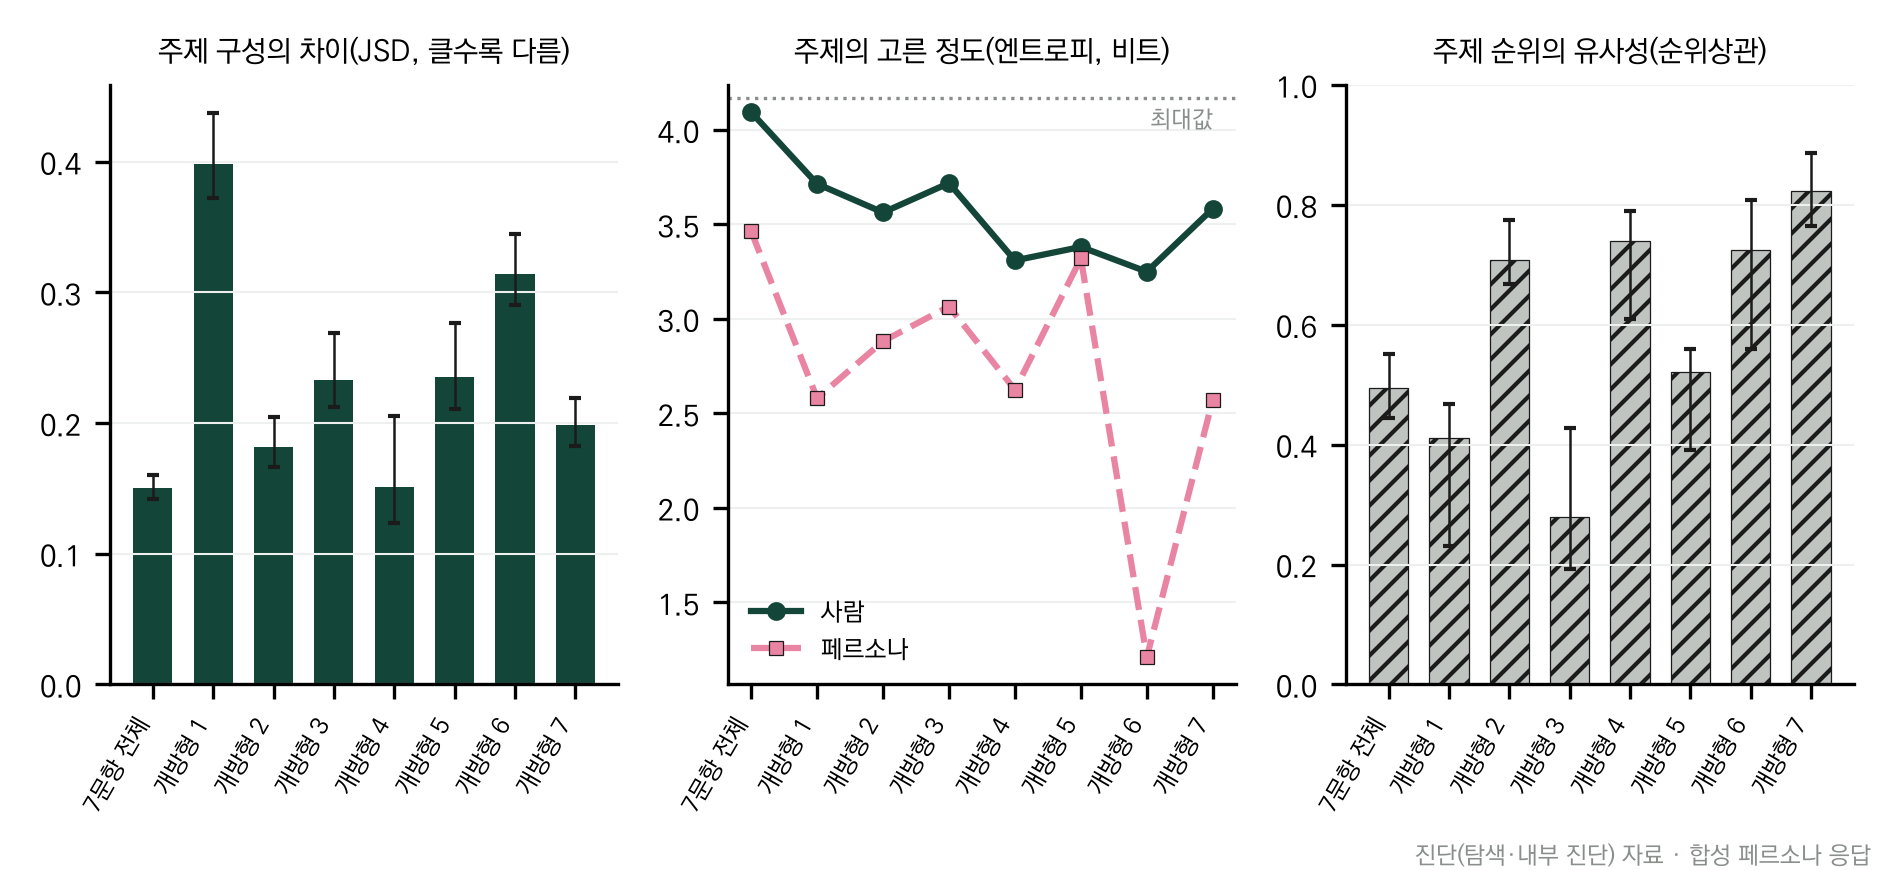
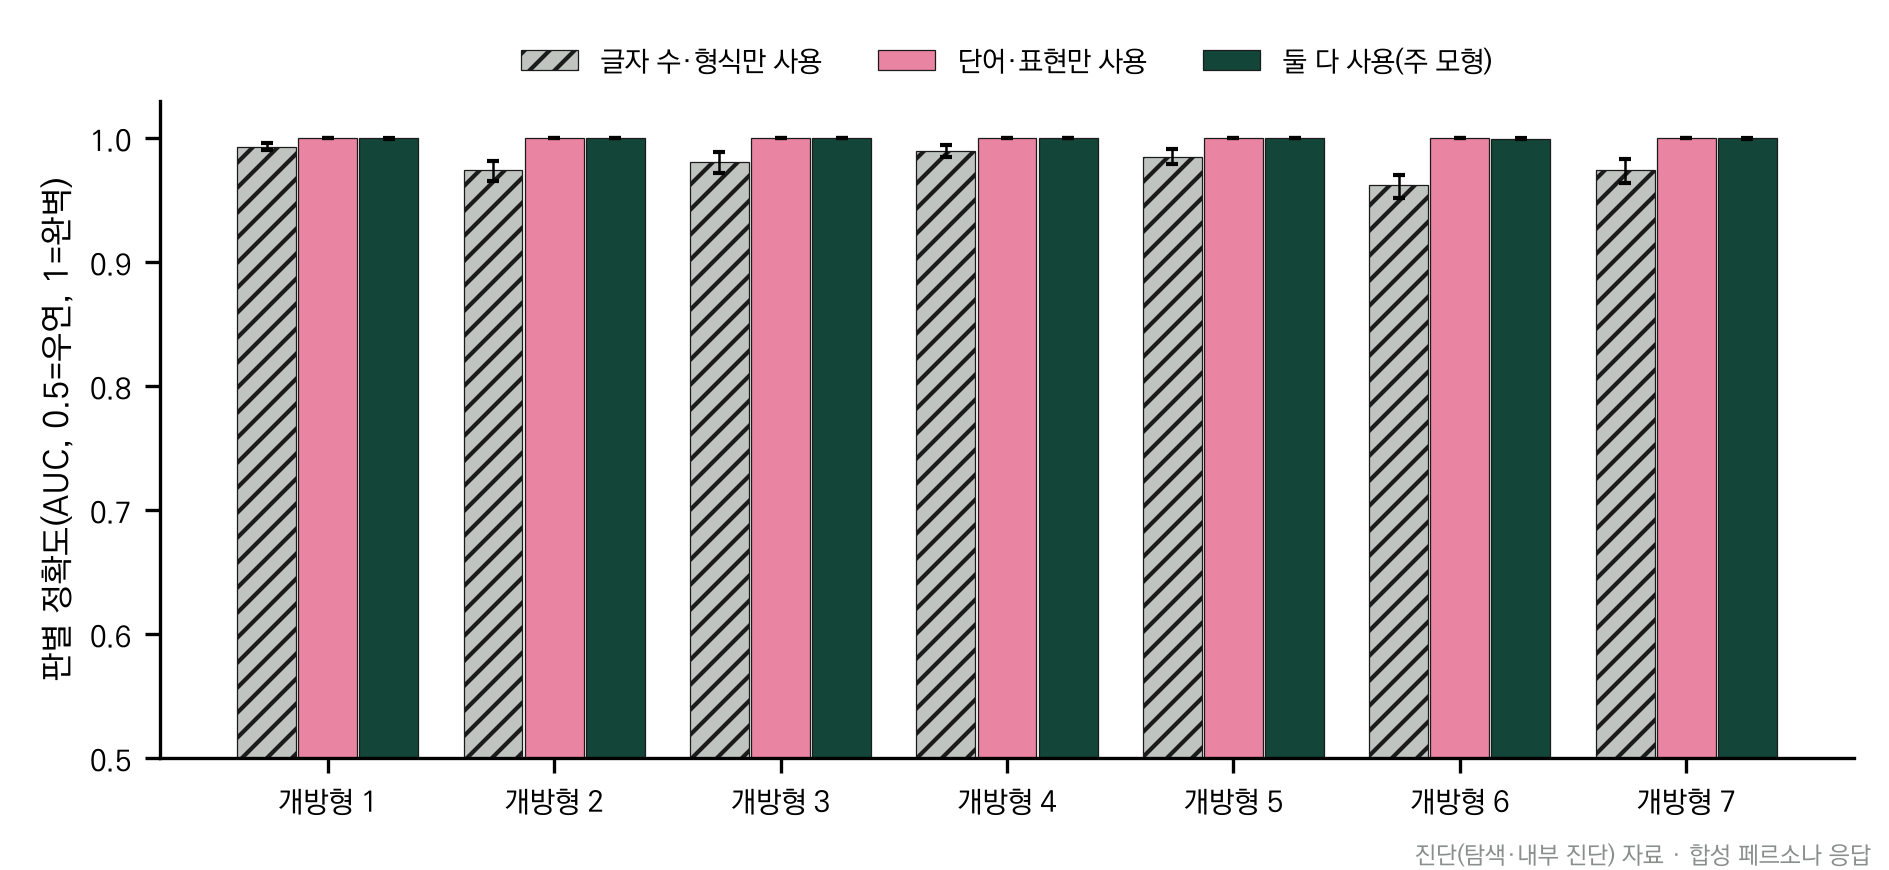
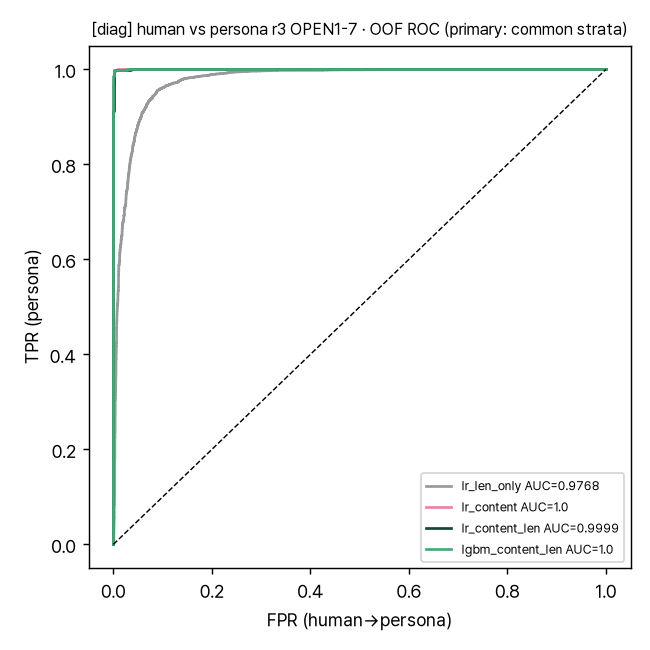
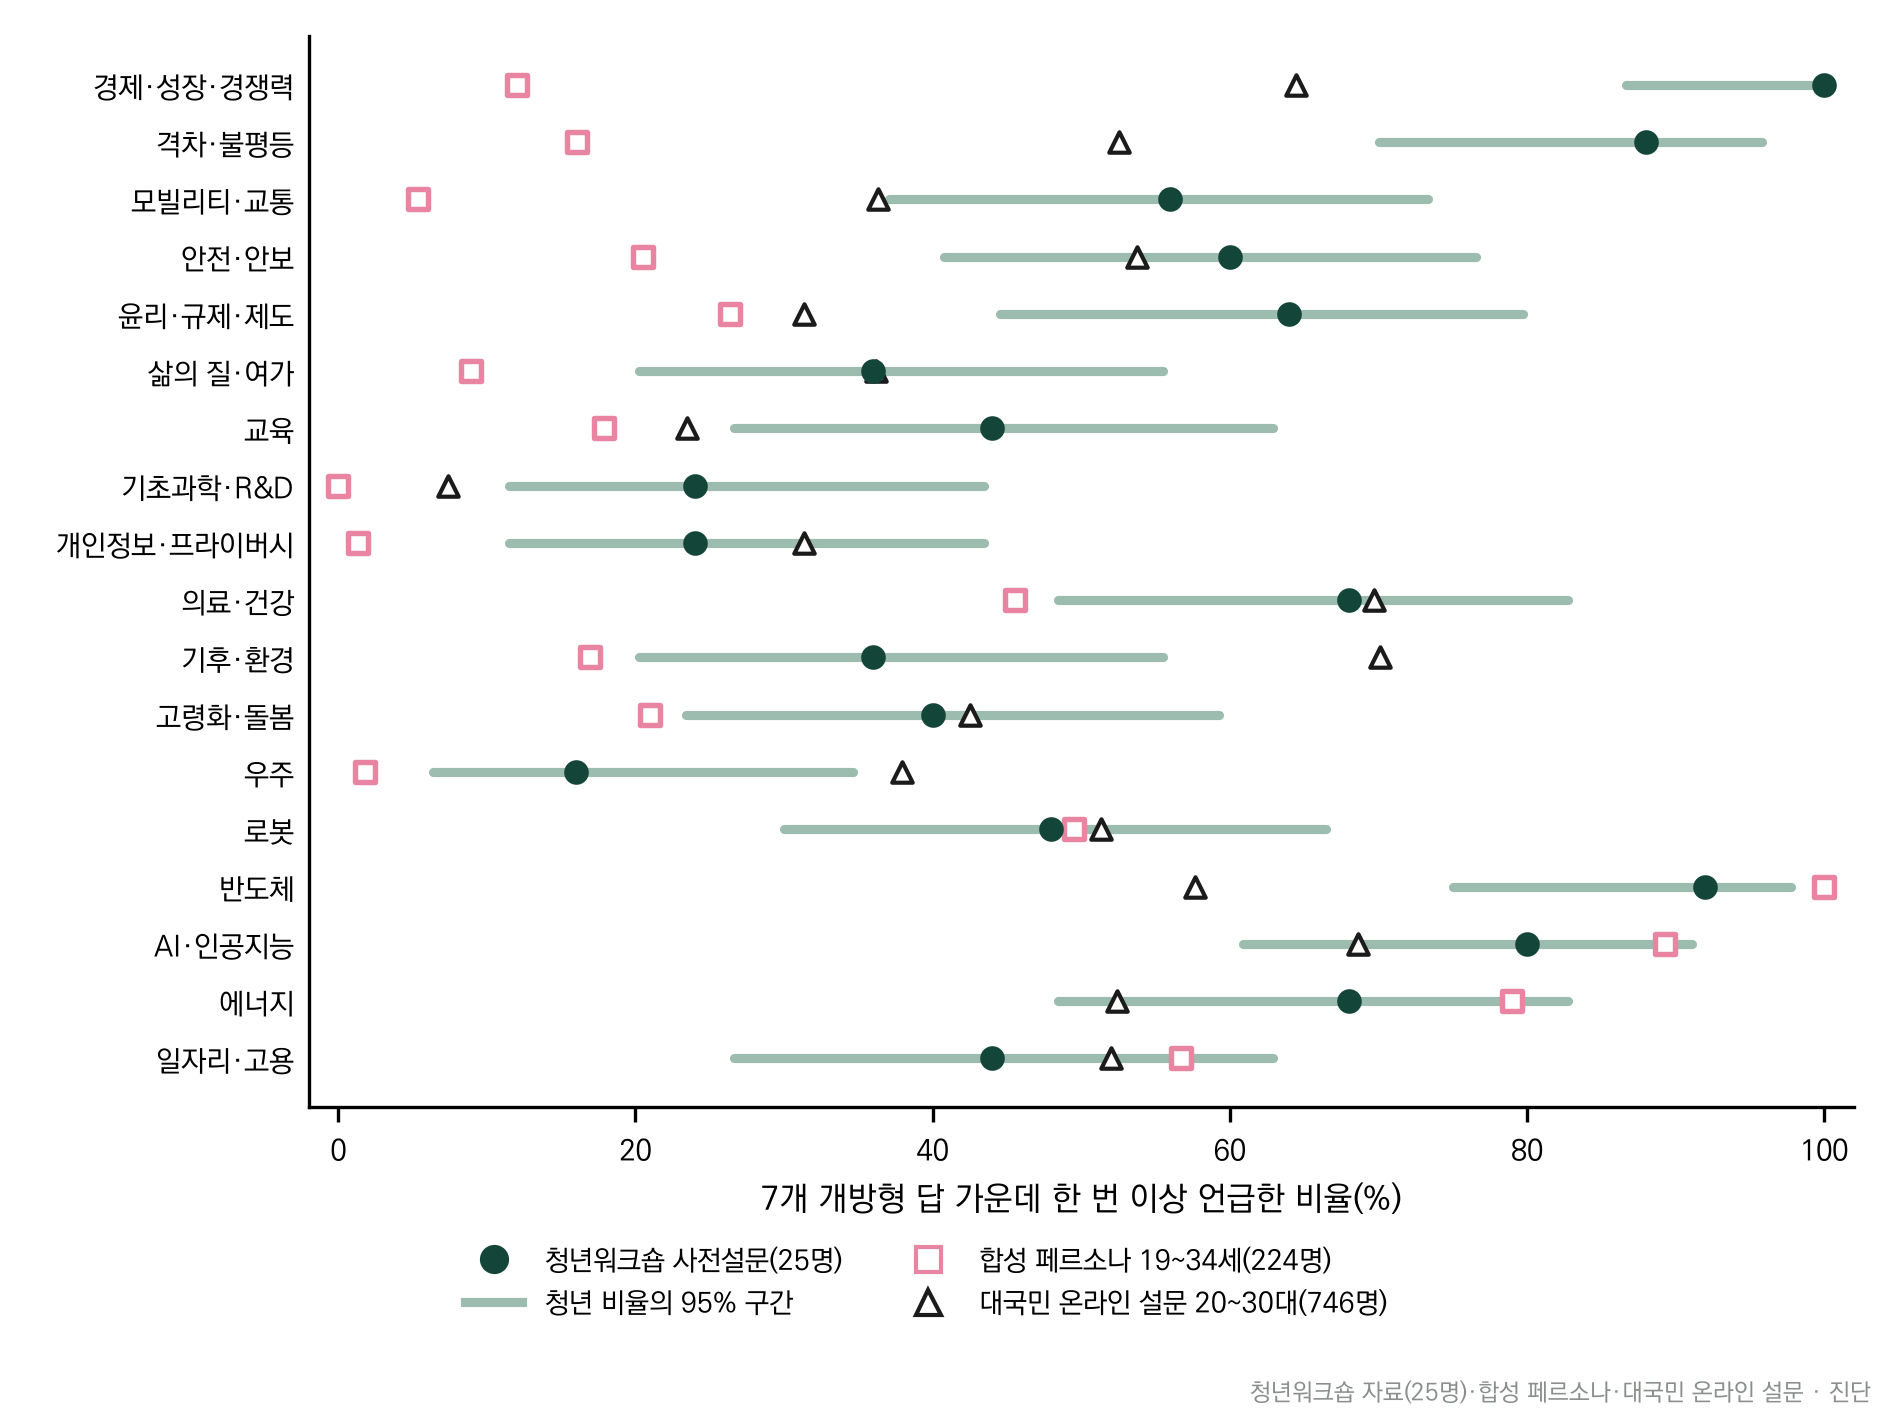
핵심 결과 — 합성 응답은 18개 주제 가운데 반도체·에너지를 뺀 16개를 사람보다 덜 언급했고 가장 큰 차이는 경제·성장·경쟁력(−72.8%p)이었다. 세 차례 수집해도 차이가 줄지 않았고(.3537, .3523, .3557), 형식 특징만으로 두 응답이 거의 구분되었다(AUC .9768). D-6 D-15 D-17
- 한계
- 사람 자료에 선택형 태도 문항이 없어 수용도의 사람 기준은 없음
- 응답 길이·표현 방식·표본 선택·분류 사전의 영향이 남음
- 9/10 코드 보완 뒤 재계산하지 않은 저장본
2026-09-27통제군·M-arm·레드팀완료합성 응답(진단)
극단·취약 페르소나 레드팀
- 질문
- 평균에 가려진 극단·취약 조건의 인물은 본조사가 놓친 어떤 우려를 말하는가?
- 규모
- 20명 × 3회 = 60응답
- 조건
- 초고령 독거, 지방 군 단위 청년, 농어업, 현장 노동, 한부모, 주거 취약, 미취업 청년 등 20개 역할 · 본조사와 겹치지 않게 추출 · 3차와 같은 모델 설정
- 모델
- Claude Opus 계열
- 보고서
- 제5장 제7절
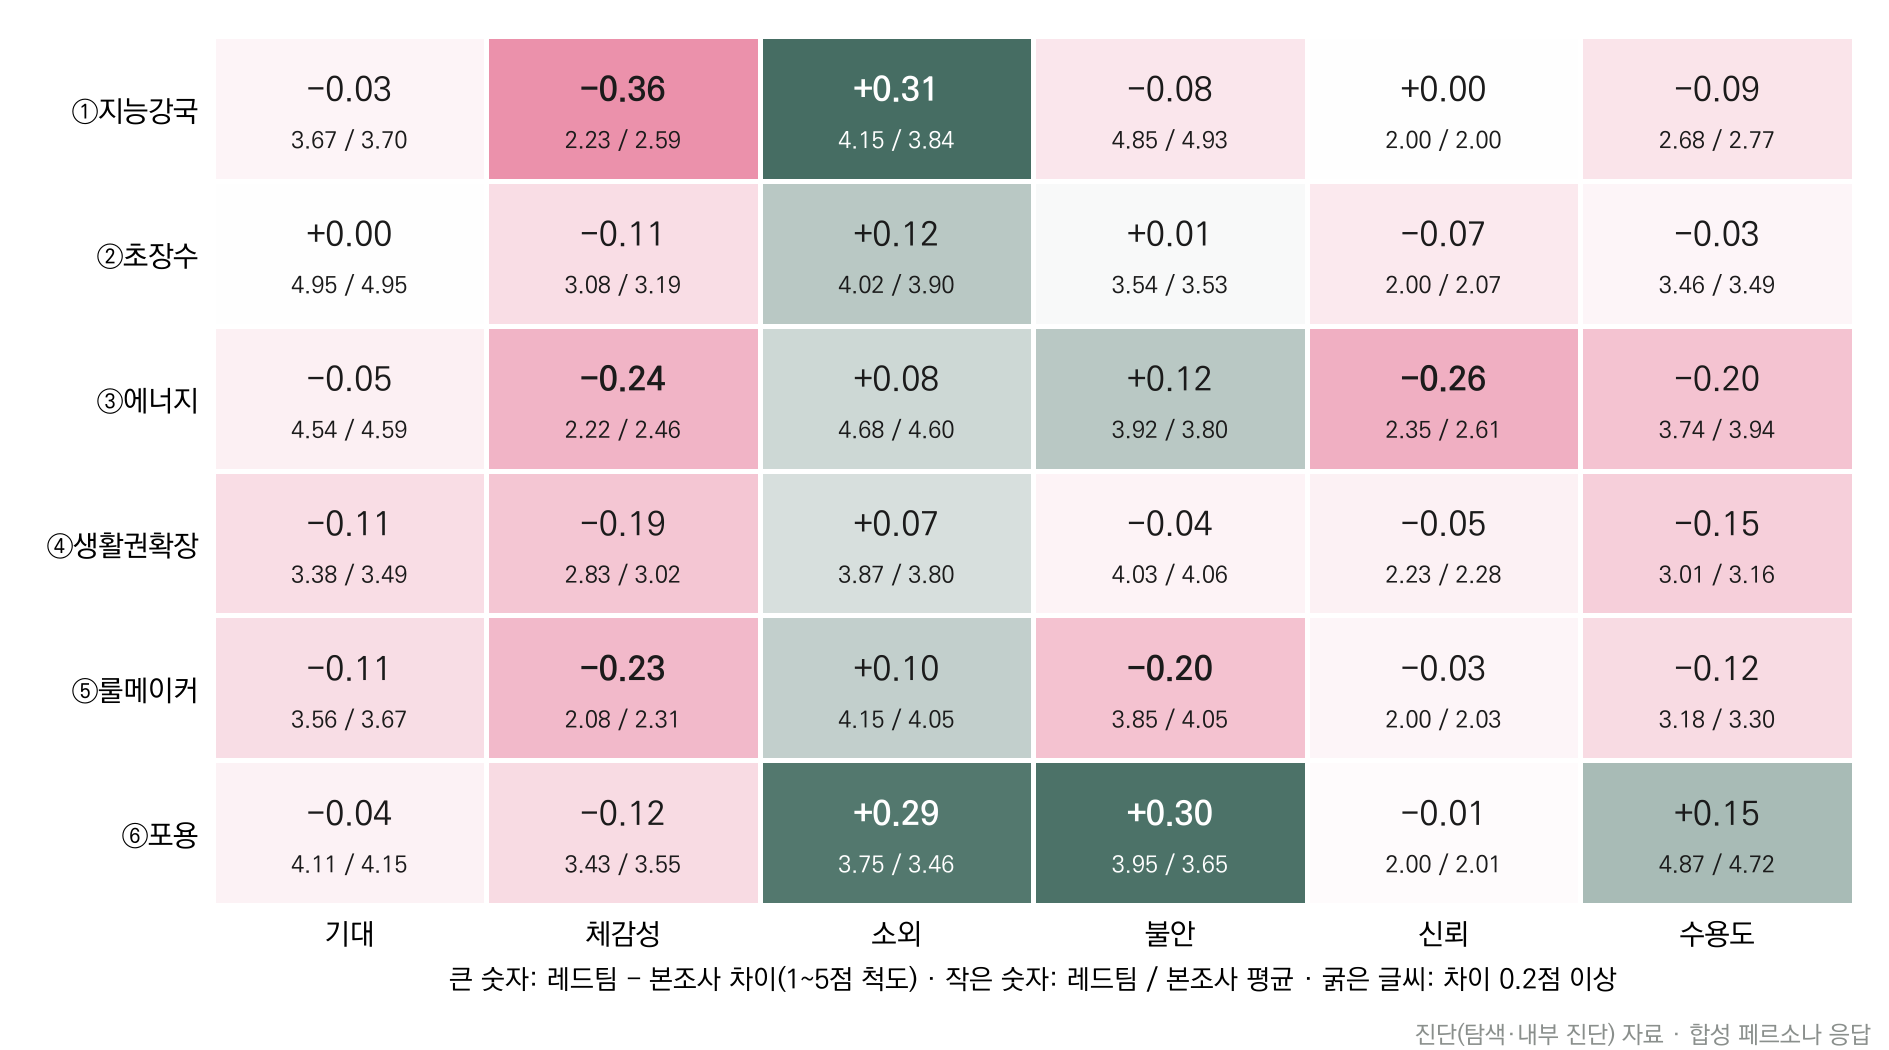
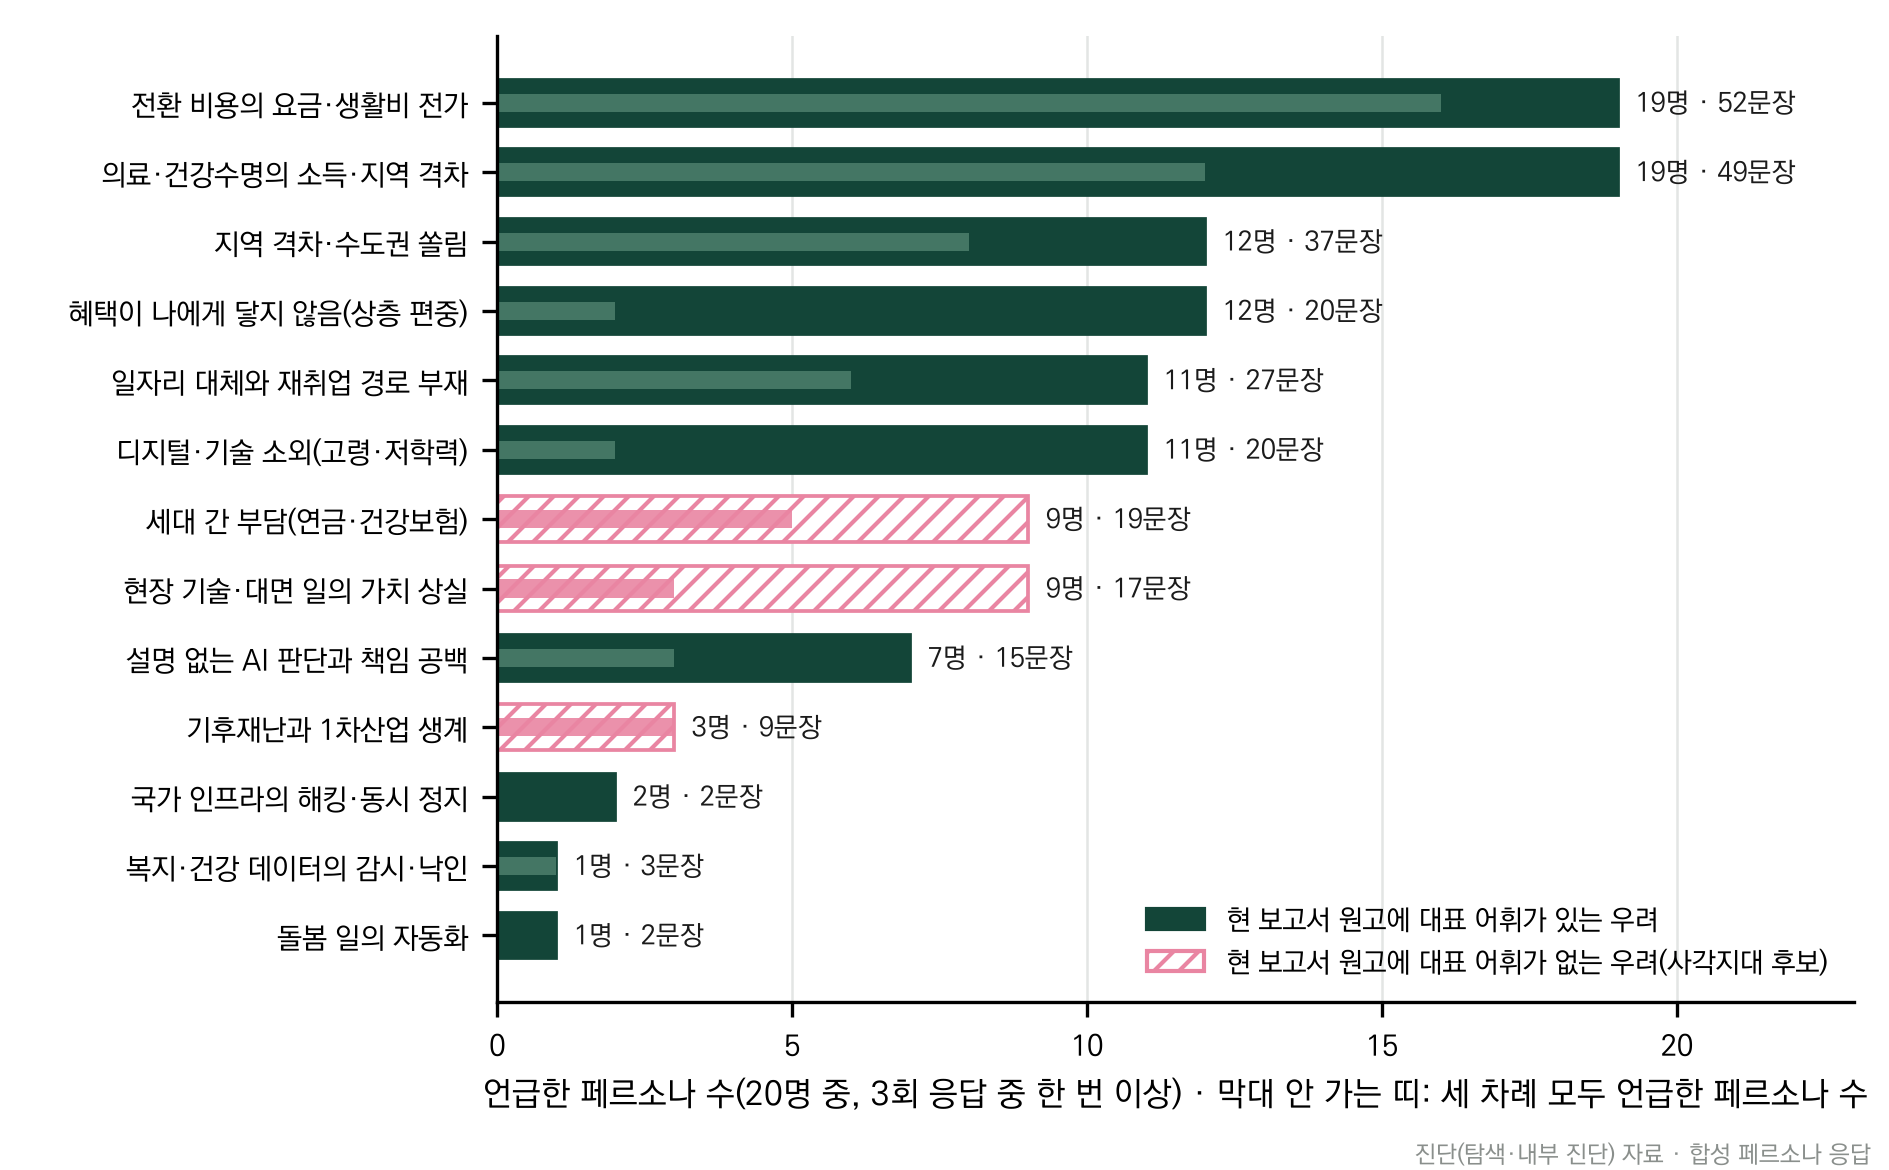
핵심 결과 — 미래상 순위는 본조사와 같았으나 체감성은 여섯 미래상 모두 낮고 소외는 모두 높았다. 요금 전가 우려는 20명 중 19명에게서 나왔다. D-22 D-23
- 한계
- 같은 20명의 반복 응답이라 독립 표본이 아니며 크기만 적고 유의성은 판단하지 않음
- 발견용이며 검증용이 아님
2026-09-27분석완료합성 응답(진단)
자유서술 코딩: 수용 조건·우려와 미래상 대응
- 질문
- 합성 페르소나가 적은 수용 조건과 우려 가운데 미래상 문장이 다루지 않는 것은 무엇인가?
- 규모
- 3차 수용 조건 3,000문장 + 우려 3,000문장 + 에세이·SNS형 각 1,000건
- 조건
- 결정론적 규칙 사전(모델 호출 0) · 입력 1,004개 파일 해시 대조 · 별도 구현 재계산
- 보고서
- 제5장 제10절, 제7장 제2절
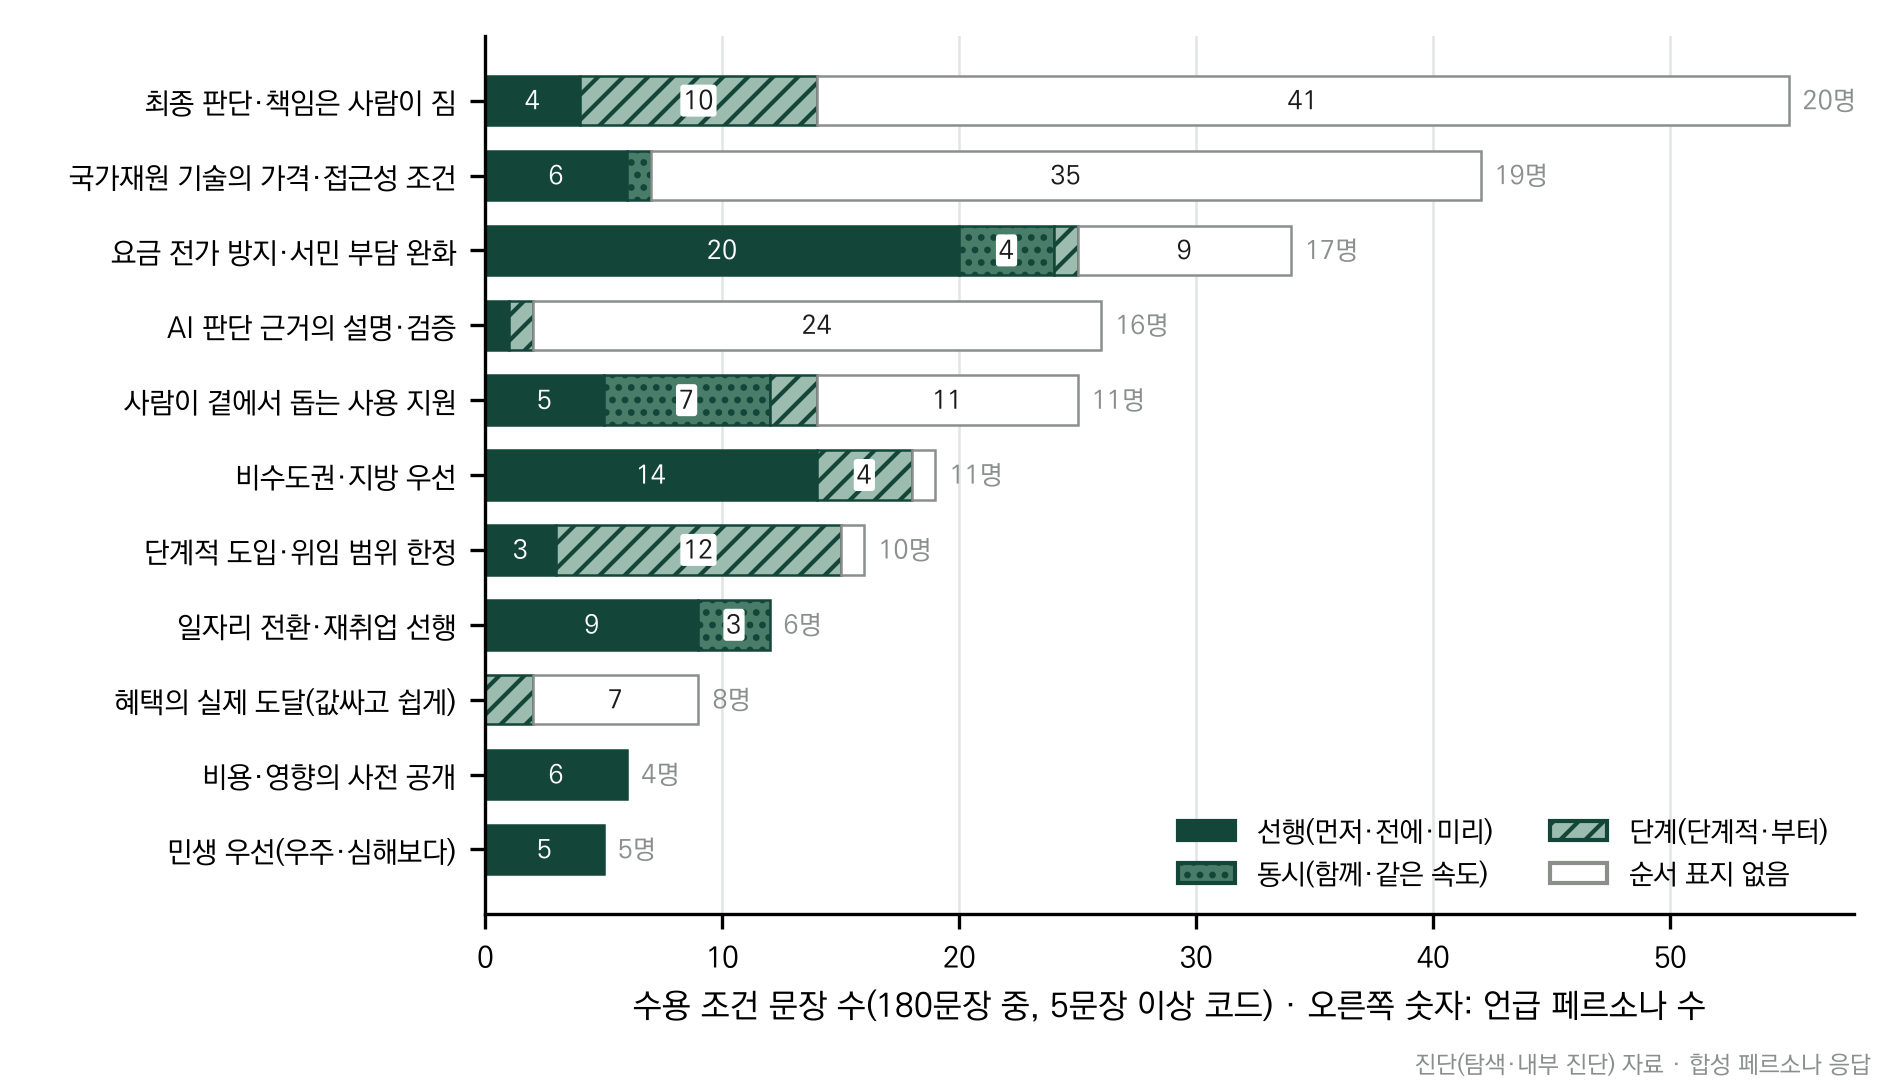
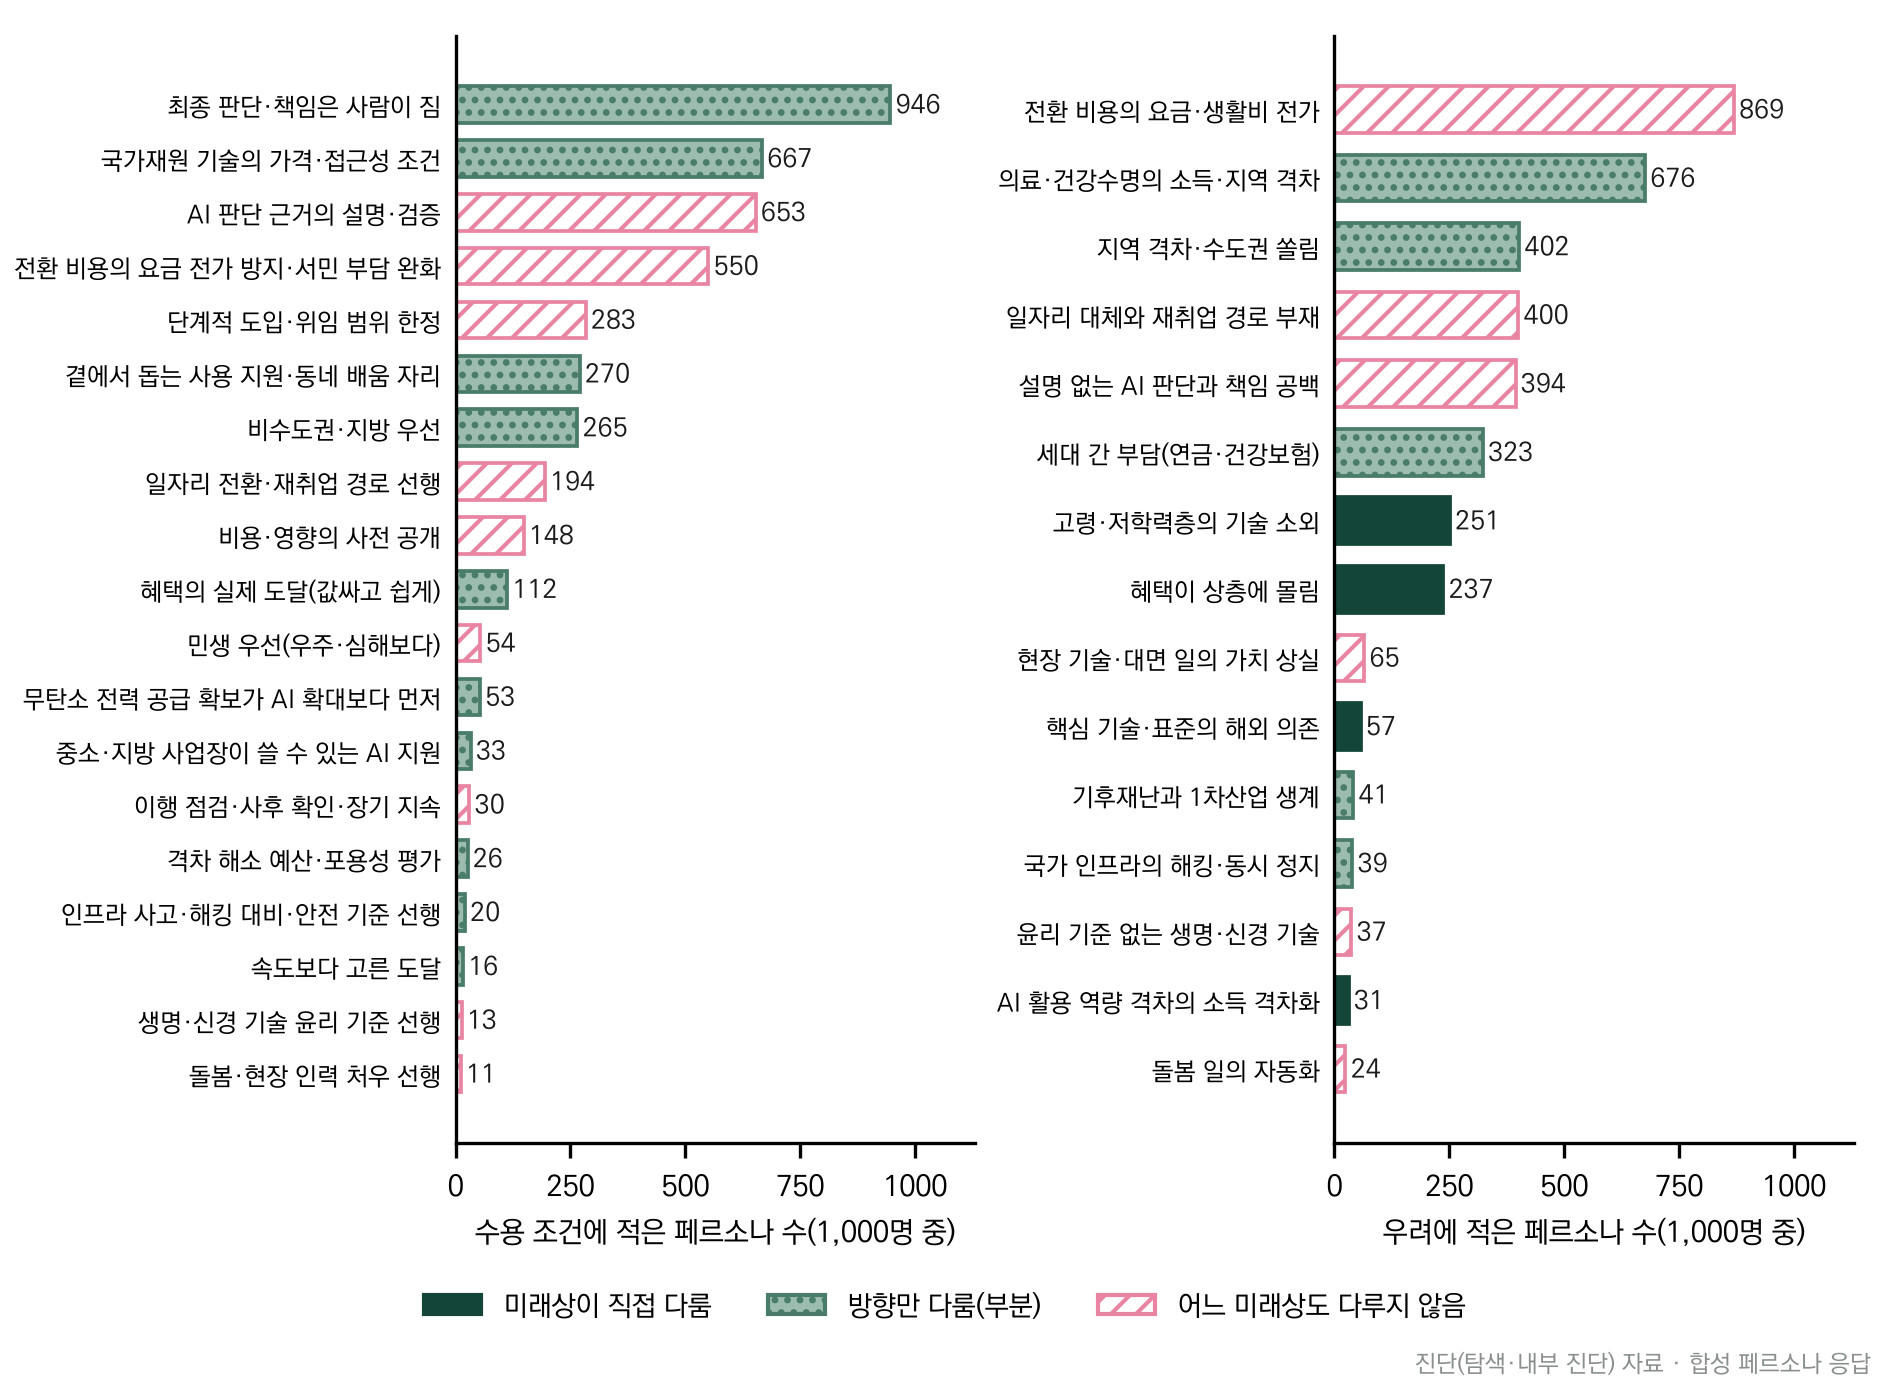
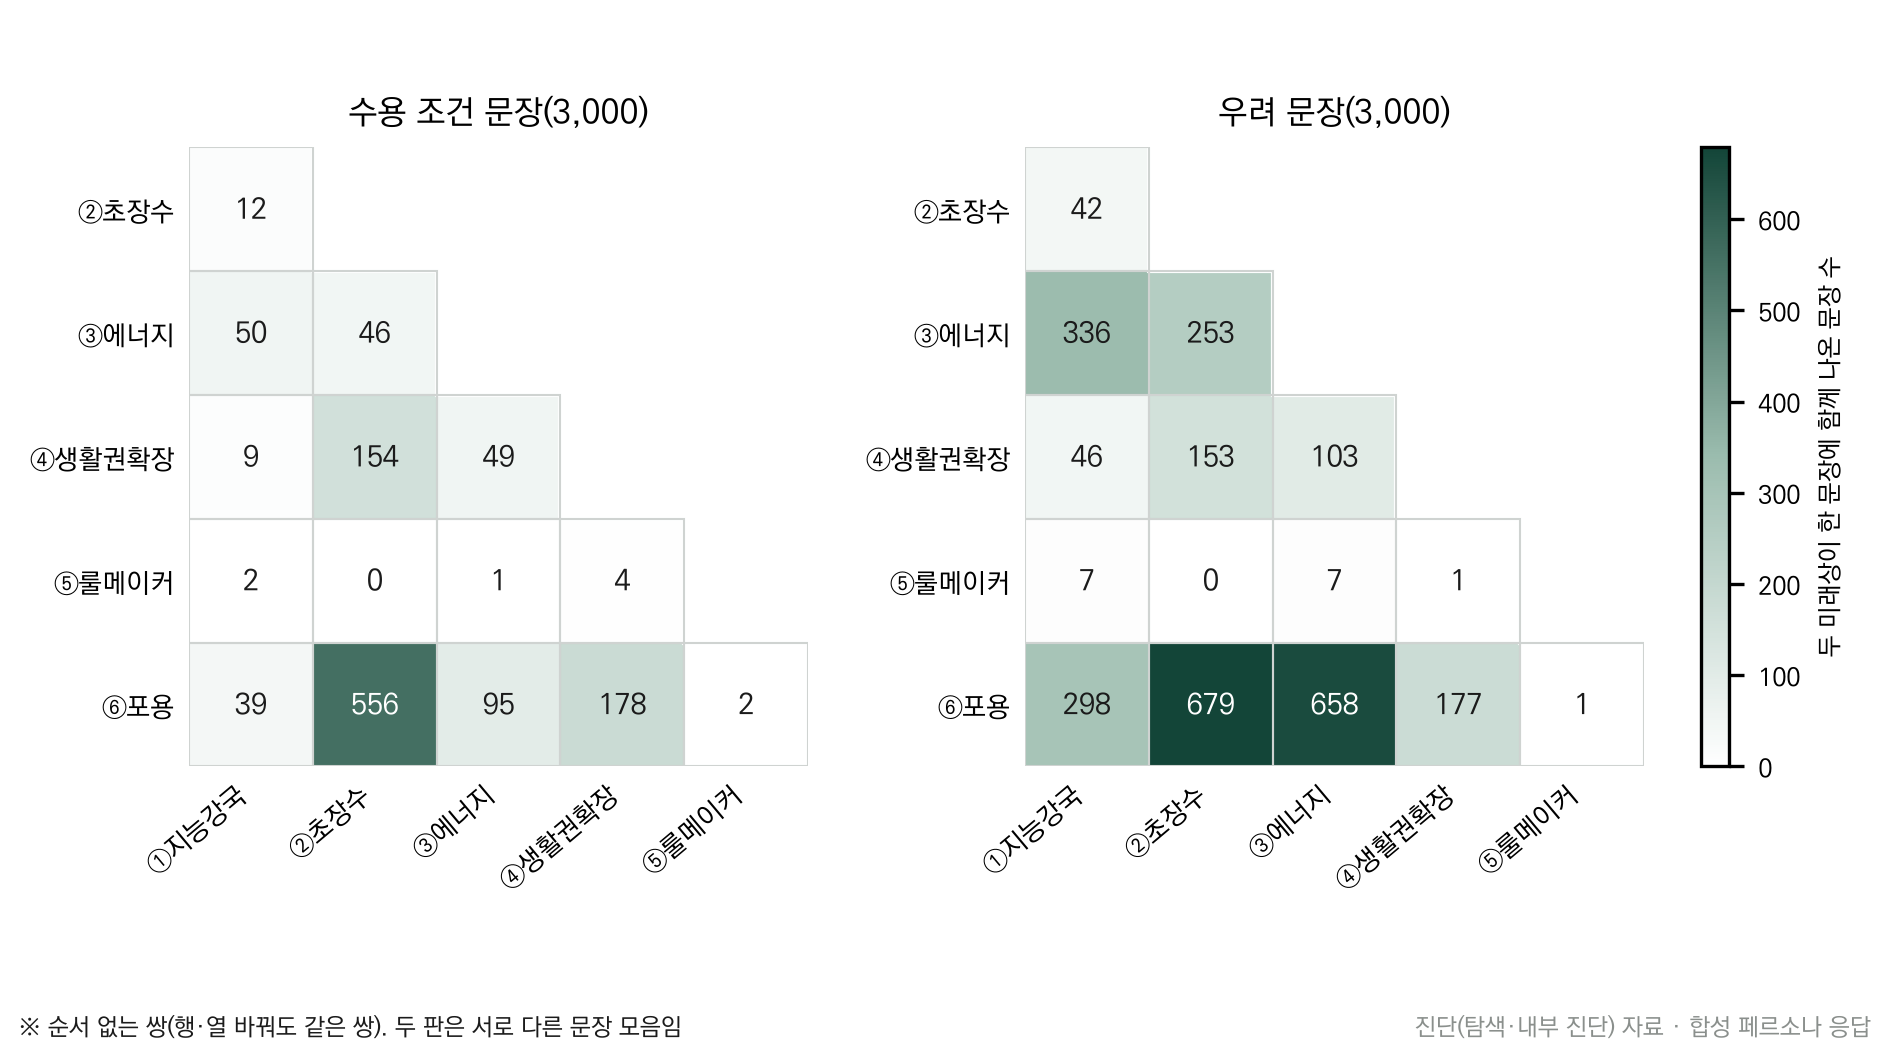
핵심 결과 — 수용 조건의 주제 언급 3,907건 중 2,347건은 미래상이 이미 다루는 주제였다. 가장 많은 요구인 요금 전가 우려(869명), AI 판단의 설명·검증 조건(653명), 일자리 대체 우려(400명)는 어느 미래상 문장에도 대응 표현이 없었다. D-25 D-26 D-27
- 한계
- 규칙 사전의 일부는 사후 작성
- 수용 조건 전체의 47.4%가 문항 문구를 되풀이함
- 사람 이중 코딩은 후속 과제
2026-09-27사람 자료 대조완료합성 응답(진단)
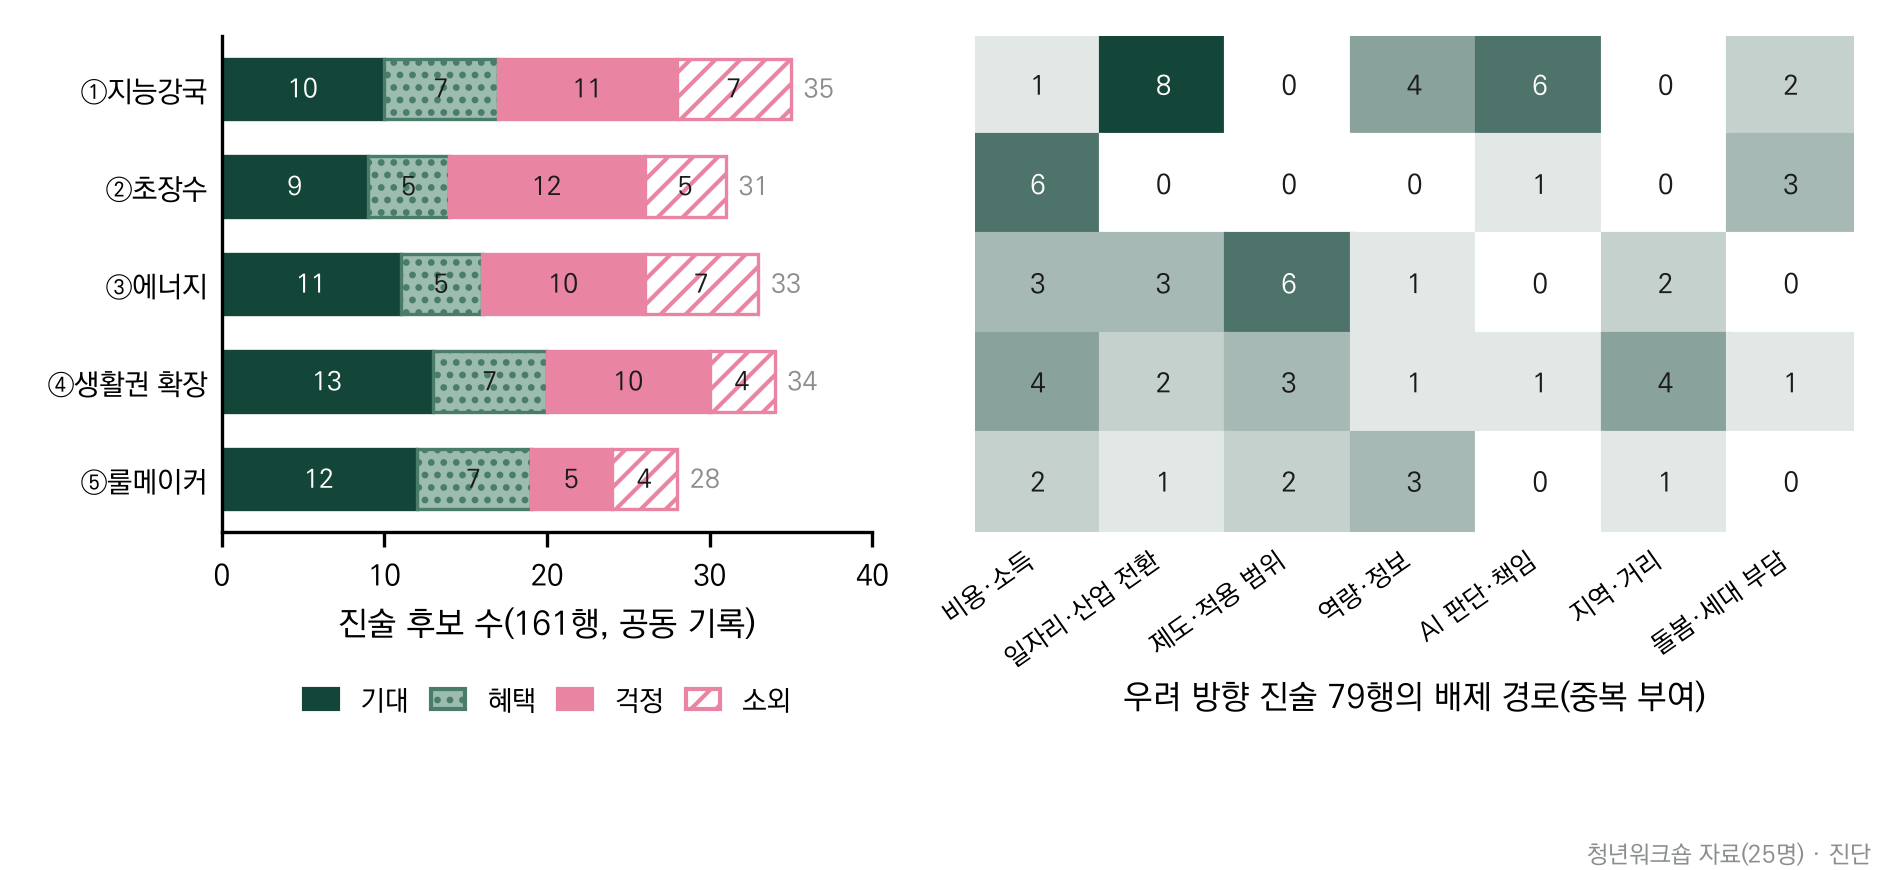
청년워크숍 대조: 참여 청년 25명 대 합성 청년 224명
- 질문
- 같은 질문에 워크숍 참여 청년과 합성 청년(19~34세)은 어디서 같고 어디서 갈리는가?
- 규모
- 참여 청년 25명(자기선택) 대 합성 청년 224명
- 조건
- 같은 17문항 · 개방형 주제 3자 비교(청년·합성·대국민 20~30대) · 사전·사후 검정 1개 사전 선언 · 월드카페·청년의 하루 집계
- 보고서
- 제6장 제4절, 부록 F
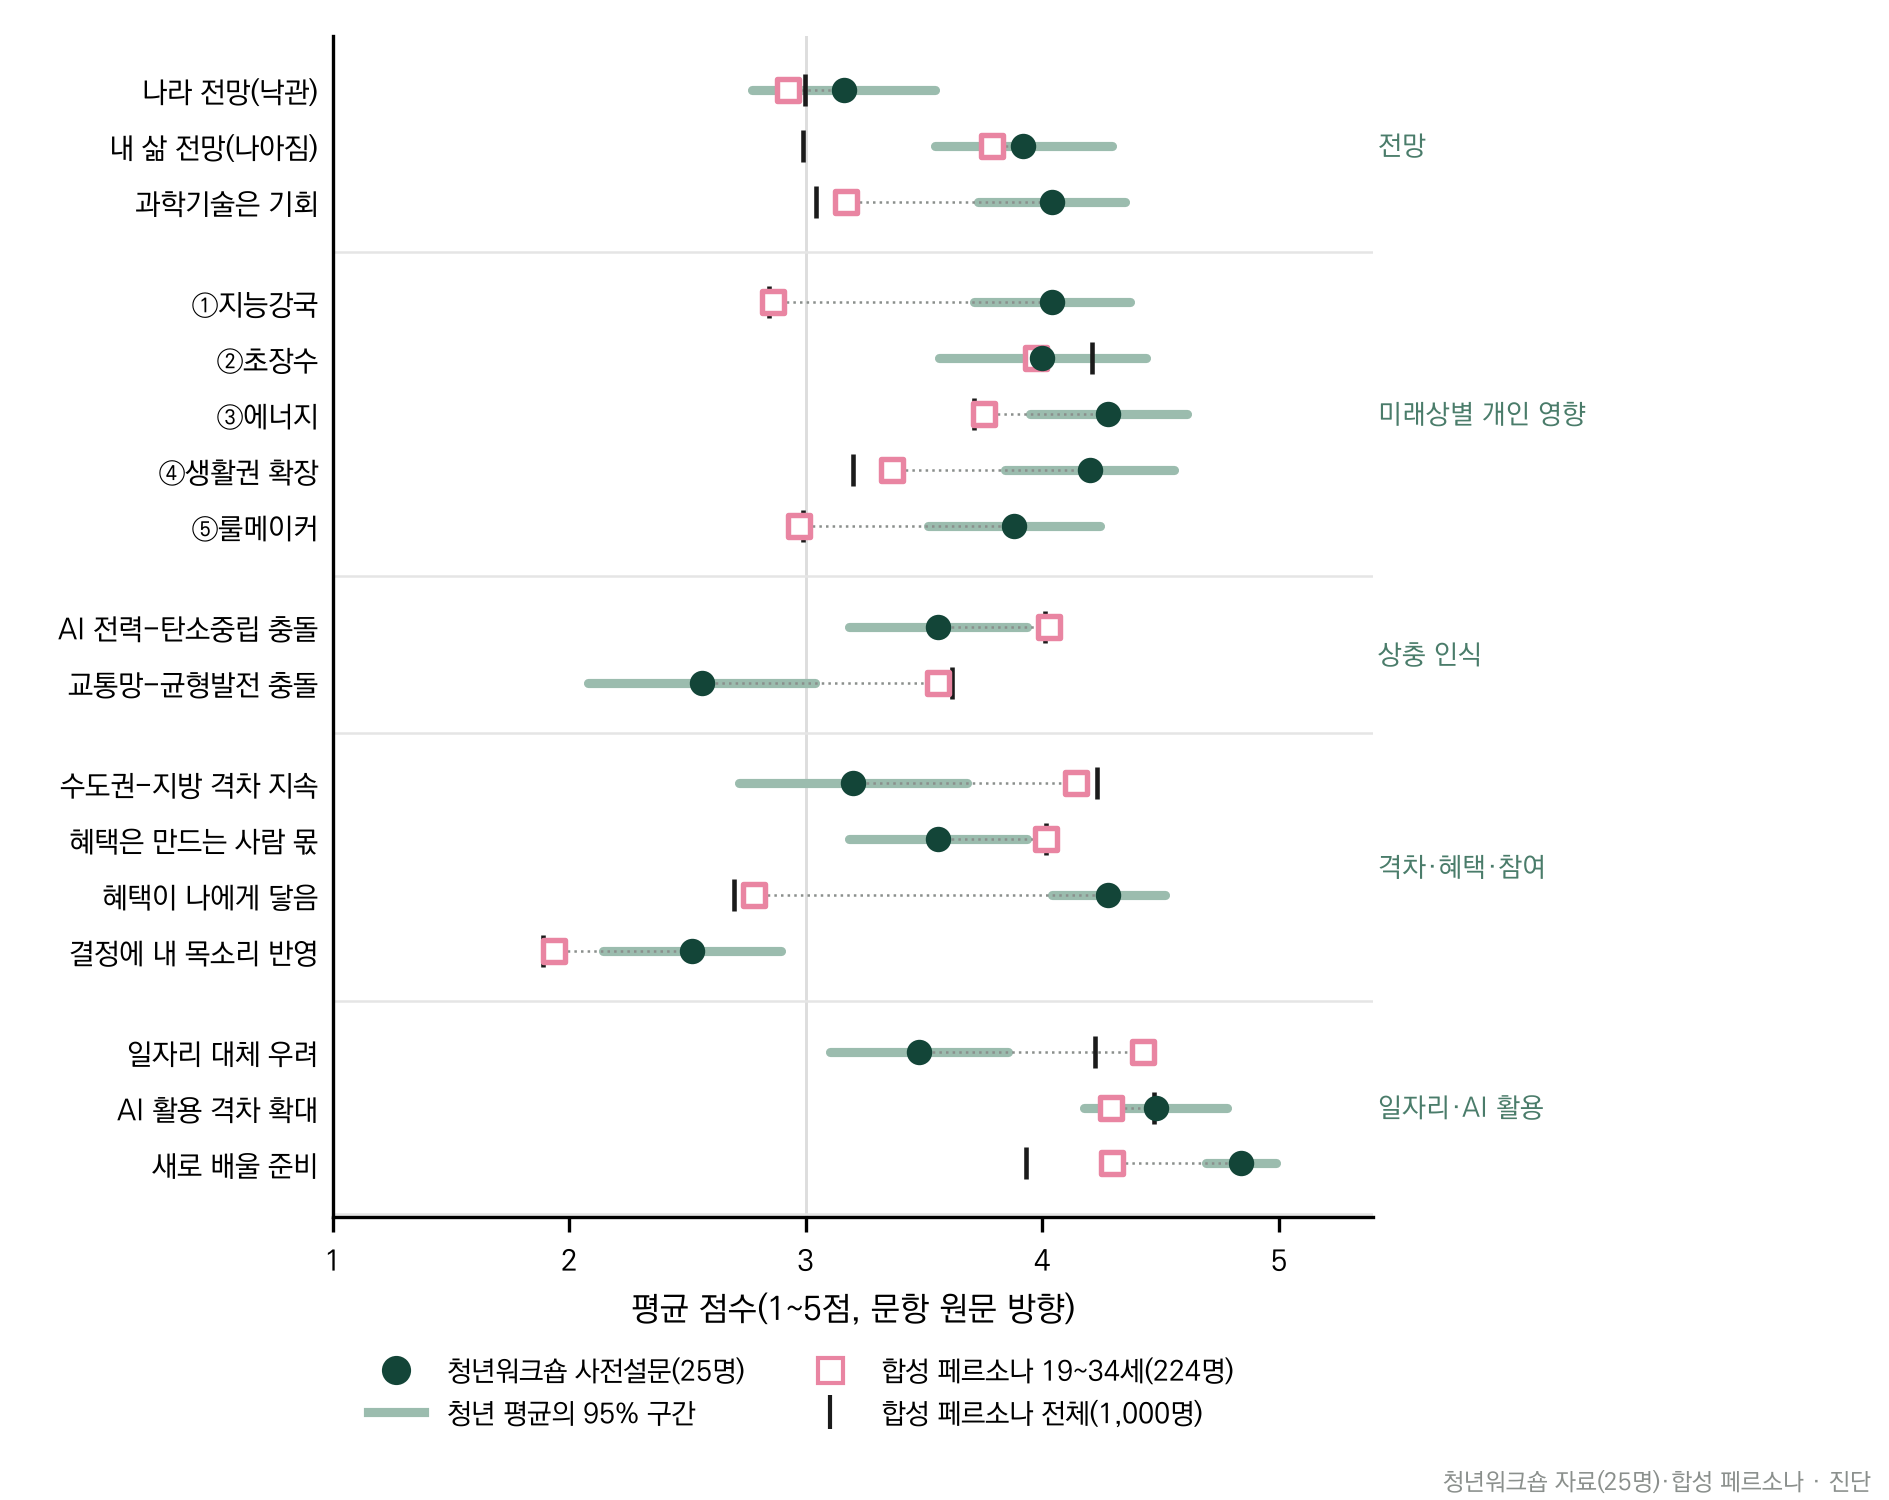
핵심 결과 — 17문항 중 11문항에서 평균의 방향이 같았으나 문항별 표준편차는 .89 대 .43이었고, '혜택이 나 같은 사람에게 닿을 것'에는 청년 92%, 합성 청년 3.1%가 동의해 방향이 반대였다. D-39 D-40 D-45
- 한계
- 참여 청년 25명은 과학기술에 관심 있는 자기선택 집단이며 진행의 영향을 받음
- 사후 설문·투표 자료의 활용 동의 범위는 기관 확인 중
- 개인 식별 정보와 직접 인용은 싣지 않음
2026-09-27합성 원탁완료합성 응답(진단)
합성 원탁회의 (2탁자 × 7석 × 4라운드)
- 질문
- 저장 응답에서 이견이 가장 큰 두 상충 지점을 토론 형식으로 두면 어떤 쟁점과 부분 수렴이 나오는가?
- 규모
- 탁자당 7석, 56발언
- 조건
- AI 인프라와 탄소중립 · 교통망과 균형발전 · 설정·좌석·첫 프롬프트 동결 후 실행 · 입력에 없는 수치·기관 인용 금지 · 동시 발언 규칙 · 요약은 별도 기록자 호출, 입장 변화표는 코드 계산
- 보고서
- 제5장 제7절, 부록 K
핵심 결과 — 합의점은 두 탁자 모두 0건이었고 부분 수렴은 4건·5건, 남은 쟁점은 4건·5건이었다. 전력 탁자 7석 중 6석이 요금 전가를 말했다. D-31 D-34 D-35
- 한계
- 탁자별 1회 실행
- 좌석 배열·맥락 배치·요약 방식의 영향은 검증하지 않음
- 사람 원탁회의를 대신하지 않으며 인용은 인간 감사 전 잠정